 웹에서의 성능 개선
웹을 이용하는 사용자의 처지에서는 서버로부터 원하는 문서와 정보를 가져올 때 좀 더 좋은 성능으로 이용했으면 하는 바램을 누구나 가질 것이다. 좋은 성능이라 함은 아래와 같은 다양한 요소들을 포함하고 있는 것이다.
2장에서는 현재의 웹에서 성능에 관계된 문제점들을 살펴보고, 3장에서는 이 문제점들에 대한 해결책 또는 성능 향상을 위한 방법들과 실험 결과들을 살펴보고, 4장에서는 결론을 맺도록 한다.
통상 말하는 성능이란 다양한 요소들을 포함할 수밖에 없다. 앞서 서론에서도 언급했던 것처럼 개인 사용자들이 사용하는 컴퓨터 시스템의 하드웨어 구성품의 질적 향상을 통해서도 성능의 향상을 기대할 수 있으며, 소프트웨어의 구현 수준이나 통신 프로토콜의 성능 및 통신망의 용량을 통해서도 성능의 향상을 기대할 수 있기 때문이다.
데이타 패킷을 송수신함으로써 이루어지는 통신망에서의 성능 향상 관점에서는 두 가지 요소를 살펴볼 수 있다. Latency와 Bandwidth라고 하는 것으로서 통신 프로토콜을 포함하는 통신망의 성능을 평가할 수 있는 주요한 요소로서 활용된다.
latency는 RTT(Round Trip Time)로서 측정할 수 있는 요소인데, 양 끝단 사이에서 패킷 하나가 왕복하는 데에 걸리는 시간이다. 따라서 송수신할 문서 데이타의 크기가 크나 작으나 항상 RTT는 일정한 시간이 된다. 이것을 향상시킬 수 있는 방법은 빛의 속도를 빠르게 하는 것이 될 수 있다.
bandwidth는 시간당 얼마나 많은 데이타 양을 전송할 수 있느냐에 따라 좌우된다. 따라서 데이타 패킷 하나를 보내는 데 걸리는 시간으로서 표현할 수도 있다. 이것을 가장 쉽게 향상시킬 수 있는 방법은 돈을 들여 보다 빠른 통신망을 연결하는 것이 될 수 있다.
이 두 가지 요소를 쉽게 비유할 수 있는 것이 수도관 파이프이다. 사용자에게 1초에 1톤의 물을 공급하고자 할 때 조그만 수도관에 물의 속도를 매우 빠르게 하여 1초 동안에 1톤을 공급할 수도 있고, 속도는 이것보다 느리지만 매우 큰 수도관을 이용하여 단숨에 1톤의 물을 보내줄 수도 있다. 사용자의 처지에서는 똑같은 결과를 가지게 되나 그 방법으로서는 두 가지가 존재할 수 있고, 속도와 용량은 상호 결합된 형태로서 사용자에서 가시적인 서비스를 제공하게 된다. 여기서 빠른 속도는 보다 짧은 시간의 좋은 latency로 대응되고 용량은 bandwidth로 대응된다 할 수 있다.
웹이 기반으로 하고 있는 TCP/IP 통신망에서의 성능은 이와 같은 두 가지 주요 관점을 기준으로 평가될 수 있으며, HTTP 응용 프로토콜의 성능 문제와 HTTP 프로토콜의 기반이 되는 TCP 전송 프로토콜의 성능 문제가 웹 서비스에서의 통신 성능을 좌우하게 된다.
서론에 언급되어 있는 다양한 성능 평가 요소들이 있음에도 불구하고 통신 성능을 통해 웹 서비스를 분석하려고 하는 것은 전체 웹 서비스에서 가장 광범위한 영향을 미치기 때문이다. 소프트웨어 구현에서 발생하는 성능 문제라면 해당 소프트웨어를 사용하지 않으면 해결되는 것이지만 데이타 송수신의 기반을 제공해주는 것인 경우에는 근본적인 설계 구조의 관점에서 성능 문제가 다루어져야 하는 것이다.
TCP/IP 프로토콜은 아래 그림 1과 같은 계층적 역할을 하는 각종 프로토콜들의 집합으로 이루어져 있다. TCP/IP 통신망은 각각의 프로토콜들의 상호 동작을 통해 데이타 송수신이 이루어진다.
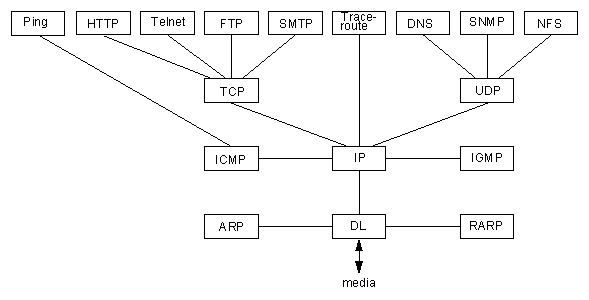
웹에서 사용하는 HTTP 데이타 전송 경로는 위 그림 1에서와 같이 TCP/IP 프로토콜 체계 상에서 TCP 연결을 통해서 이루어진다. 그러므로 브라우저를 이용하여 서버의 어느 홈페이지 내용을 갖고 오기 위해서는 HTTP 프로토콜을 이용한 문서 요청을 해야 하고, 서버는 이에 대한 응답을 보내주게 된다. 이 과정에서 HTTP 프로토콜은 요구 메시지를 전달하고 응답을 수신하기 위한 하위의 TCP 연결을 클라이언트와 서버 사이에 먼저 만들어야 한다. 다시 말해서 서울 부산 사이의 제품 수송을 위해서 먼저 고속도로가 건설되어 연결되어 있어야 하듯이, HTTP 메시지 송수신을 위해서는 먼저 TCP 연결부터 맺어야 하고 그 다음에 HTTP 메시지의 전송이 설립된 TCP 연결을 통해 이루어진다.
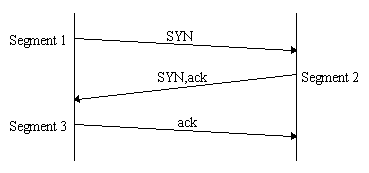
TCP 연결을 맺을 때는 아래의 그림 2와 같은 three-way handshake라고 하는 방법을 사용한다.
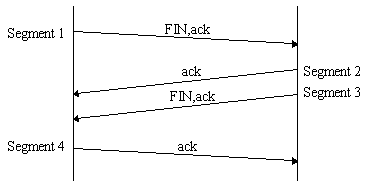
[그림 3] TCP 연결 해제 과정
서버에서는 SYN 패킷을 수신하고 자신의 데이타 전송을 위한 SYN 패킷을 보낸다. 이 패킷 속에는 서버 자신이 사용할 순서 번호의 첫 숫자가 들어가 있고 뒤이어 보낼 데이타 패킷의 첫 번째 바이트의 일련 번호 시작을 알려주게 된다. 이와 함께 앞서 클라이언트가 보낸 SYN 패킷을 성공적으로 수신했다는 의미로서 ack 정보를 함께 보낸다. 여기서의 ack 정보는 클라이언트로부터 전달받은 순서 번호에다 1을 더한 숫자가 된다. 이와 같은 ack 정보의 의미는 앞서 보낸 패킷을 잘 받았으며 앞으로 내가 받고자 하는 패킷의 순서 번호는 지금 알려주는 번호이다 라는 것을 뜻한다. 이러한 과정에서 사용하는 순서 번호는 데이타의 바이트 단위로 증가하는 것이며 패킷당 1씩 순서 번호가 증가하는 것이 아니다.
클라이언트에서는 서버로부터 수신한 SYN 패킷에 대해 성공적인 수신을 알리는 ack 패킷을 보내게 되고, 이 속에 들어가는 순서 정보는 서버의 SYN이 알려준 순서 번호보다 1이 큰 숫자이다. 즉, 앞으로 서버로부터 수신하고자 하는 패킷의 첫 순서 번호를 알려주는 것이다. 그 다음 패킷의 첫 순서 번호는 바로 앞에 전송했던 패킷에서 데이타의 총 바이트 수를 더한 숫자가 될 것이다.
따라서 TCP 연결을 새로 만들 때는 항상 세 번의 end-to-end 패킷 전송 시간이 걸리게 되며, 하나의 서버로부터 동시에 다섯 개의 TCP 연결을 맺어서 다섯 개의 데이타 화일을 가져오려 할 때 다섯 번의 똑같은 TCP 연결을 위한 지연시간이 생기게 된다.
이러한 문제는 동시에 같은 서버로부터 화일을 가지고 오려 할 때 생기기도 하지만, 연이어서 몇 개의 문서 화일을 가지고 오려 할 때도 생긴다. 사용자들은 하나의 서버에 접속하여 문서를 보았을 때, 해당 문서와 관련된 다른 문서들을 같은 서버로부터 연속적으로 읽어보고자 할 수 있는 것이다.
HTTP 연결은 요구/응답으로서 이루어지는 웹 통신 프로토콜이며 서버가 문서 화일을 전송하고 나면 자동으로 연결을 끊어버리는 구조로 되어 있다. 따라서 연속적인 문서 요청이라 할지라도 매번 TCP 연결을 맺어야 하며, 연결 설립은 위한 시간 지연은 매번 계속 생기게 된다.
HTTP와 같은 응용 프로토콜로부터 넘겨 받은 사용자 데이타를 TCP 패킷 속에 넣어서 전달할 때, TCP가 다룰 수 없는 정도의 큰 크기라면 적절한 크기로 잘라서 전송하게 된다. 이렇게 잘라낸 각각의 데이타 조각들을 세그먼트라고 하며, 세그먼트의 최대 크기를 MSS(Maximum Segment Size)라고 한다. 이 세그먼트에 TCP 헤더를 붙여서 전송하게 된다.
이 크기는 클라이언트와 서버 사이에 서로 협상하여 결정할 수 있으나 선택적인 것이므로 어느 한 쪽이 이 기능을 사용하지 않을 수도 있다. 이 기능을 사용하지 않고 협상 없이 진행되는 TCP 연결에는 기본적으로 536 바이트로 설정된다. 특히 원거리로 접속되는 TCP 연결은 최소 크기인 536 바이트로 설정되기 때문에 좀 더 큰 세그먼트로 전달할 수 있음에도 불구하고 불가능하게 되며, 결과적으로 같은 크기의 데이타를 전달할 때 더 많은 갯수의 TCP 패킷이 전송되어야 한다.
이것은 TCP의 본래 문제이며 결과적으로 응용 서비스의 성능에 영향을 미치게 된다.
TCP 프로토콜은 end-to-end의 양 끝단에서 오류가 전혀 없는 완전한 데이타 신뢰성을 보장해주는 프로토콜이다. 그러므로 중간에서 패킷의 손상이나 손실에 의해 오류가 발생했을 때는 송신측으로부터 재전송을 받아야 한다. 이러한 신뢰성을 위해 수신측에서 TCP 패킷을 정상적으로 제대로 받았다면 송신측에게 잘 수신했음을 알려주어야 한다.
만약 송신측으로부터 수신측까지 패킷을 전송하는 데에 한 시간이 걸린다고 가정할 때, 송신측이 수신자가 패킷을 제대로 수신했음을 알기까지는 두 시간이 걸릴 것이며, 그런 다음에 또 다른 패킷을 전송한다면 송신측에서는 하나의 패킷을 보내고 두 시간을 기다린 후에야 다른 패킷을 보낼 수 있게 될 것이다. 이러한 방식은 성능에 심각한 문제를 일으키는 것이다.
그래서 수신측에서 성공적인 수신을 알려주지 않았더라도 송신측에서 계속 TCP 패킷을 보낼 수 있도록 하고 있다. 그러나 만약 수신측으로부터 아무런 응답이 없음에도 송신측에서 무한정 패킷을 계속 보내게 되면, 수신측에서 버퍼 오버플로우가 생길 우려가 있고 연속적인 재전송 동작이 수행되어야 하는 악순환이 생기게 된다.
이러한 문제를 해결하기 위한 방법이 '윈도우'라고 하는 것이다. 적절한 윈도우 크기를 정해 두고, 이 범위 안에서만 수신측으로부터 수신 성공의 응답이 없더라도 송신측에서 계속 TCP 패킷을 보낼 수 있도록 하고 있다. 윈도우 크기가 모두 소진되고 나면 송신측은 전송을 중단하고 수신측으로부터 수신 성공 응답을 (acknowledgments) 기다린다. 성공적인 수신이 통보되면 송신측은 만약의 재전송을 위해 버퍼 속에 남겨두었던 데이타를 지워도 되고 그만큼의 윈도우를 더 확보하게 된다. 확보된 윈도우를 바탕으로 송신측은 다시 전송할 수 있게 된다.
이러한 윈도우를 통해 데이타 전송량을 제어할 수 있음에도 불구하고, 수신자는 현재 통신망의 트래픽 과다 여부를 알 수 없으며 송신자에게 이 사실을 알릴 수도 없다. 그러나 송신측에서는 수신측으로부터 도착하는 응답을 통해 시간 계산을 하여 트래픽의 과다 여부를 짐작할 수 있다. RTT가 일정한 수준을 유지하다가 갑자기 증가했다면 현재 네트워크의 트래픽 과다를 추정해볼 수 있는 것이다. 수신측에서는 송신측으로부터 언제 패킷이 도착할지 모르므로 수신측에서는 알 수 없다.
따라서 송신측에서 윈도우 범위 내에서 패킷을 연속적으로 전송하게 되면 트래픽 과다의 경우에 더 심각한 문제를 야기시키게 된다. 이 문제를 예방하기 위해 송신측에서는 미리 윈도우 크기를 최소로 잡아 놓고 패킷을 전송하게 되며, 수신측의 응답으로부터 트래픽의 혼잡이 없이 정상적인 통신 상황임이 확인되면 윈도우의 크기를 증가시킨다. 이러한 과정을 통해 윈도우의 크기가 점점 증가되고, 어느 순간 트래픽의 혼잡이 발견되면 현재의 윈도우 크기를 절반으로 줄이고 다시 돌아온 수신측 응답으로부터 여전히 트래픽 혼잡이 발견되면 다시 윈도우 크기를 절반으로 줄임으로써 지수함수적으로 감소시킨다. 그러다가 적정한 RTT 값으로서 정상적인 네트워크 상황이 되면 윈도우 크기가 다시 순차적으로 증가한다. 이것이 슬로우 스타트라고 하는 동작 알고리즘이다.
이 방식의 문제점은 현재의 통신망 상황이 매우 좋음에도 불구하고 조그만 윈도우 크기로부터 시작한다는 것이다. 만약 송수신할 데이타의 양이 많아서 오랜 시간 동안 TCP 연결을 맺어 두고 있다면 이와 같은 문제는 무시할만한 것이다. 그러나 송수신할 데이타의 양이 적어서 짧은 시간 동안 존재하는 TCP 연결이라면 이러한 슬로우 스타트 알고리즘은 성능을 효과적으로 발휘할 수 없게 만드는 요소이다.
HTTP 프로토콜과 같이 요구/응답의 방식으로 동작하며 비교적 짧은 시간 동안에 데이타 송수신이 끝나는 응용에서 슬로우 스타트는 성능을 저하시키는 요소이다.
이것은 그리 심각한 문제를 일으키는 것은 아니지만 성능과 관련이 있는 요소인 것은 사실이다. 서버가 데이타를 전송한 후에 TCP 연결을 해제하게 되는데, 예기치 않은 지연된 패킷이 수신측에 도착하고 이로써 비롯된 추가적인 오류 제어가 필요할 수 있다. 그러므로 해제된 TCP 연결에 대한 상태정보를 일정 시간 동안 저장하고 있어야 하며, 이 시간 동안 TIME_WAIT 상태에 있게 된다. 이 시간은 통상 240초로 정해져 쓰이고 있으며 이 시간 동안 시스템 자원은 할당된 채로 다른 용도로 활용될 수 없다.
TCP 연결에 대한 부하가 크지 않은 시스템에서는 이러한 과정이 별다른 영향을 미치지 않으나, 검색엔진과 같은 활용 빈도가 매우 높은 서버에서는 수많은 TCP 연결이 설립되었다가 해제되는 동작이 진행되며 이때 상당한 영향을 미치게 된다. 그래서 새로운 TCP 연결 요구에 대한 적절한 응답을 해줄 수 없는 상황이 생길 수 있다.
화일 송수신을 위한 응용 서비스인 FTP에서 사용하는 FTP 프로토콜은 일반적으로 장시간의 TCP 연결이 설립되게 되고 응용 프로그램에서 전달하는 사용자 데이타의 크기도 큰 편이다. 이 데이타가 여러 개의 TCP 세그먼트로 분할되고 2.2절에서 설명한 대로 세그먼트 크기가 최소로 된다 할지라도 HTTP 프로토콜보다는 나은 상황을 만든다. 왜냐하면 요구/응답 메커니즘으로 이루어지는 HTTP 프로토콜에서는 비교적 조그만 데이타 양을 가지는 패킷들의 연속적인 교환으로 이루어지기 때문에 결과적으로 더 많은 갯수의 TCP 세그먼트를 양산하게 될 수 있다.
이것은 웹에서의 통신 성능은 bandwidth에 관련된 요소보다 latency에 관련된 요소들에 의해 좌우된다는 것을 뜻한다. 많은 갯수의 TCP 세그먼트는 통신망의 부하를 더 높이고 결국 latency를 악화시키는 것이며, 웹에서의 통신 성능을 위해서는 latency를 줄이고 교환해야 할 TCP 세그먼트를 줄이는 것에서 출발한다.[3]
bandwidth를 이용한 성능 향상은 돈을 더 투자하여 더 넓은 전송 대역폭을 갖는 통신 회선을 연결하면 된다.
웹 브라우저와 서버 사이의 통상적인 메시지 교환을 그림으로 그려 보면 아래와 같다.[3]
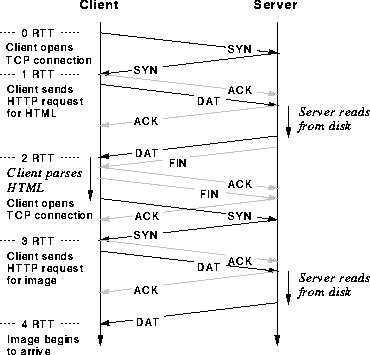
대부분의 HTML 문서 속에는 여러 개의 그림 화일을 포함하고 있는데 모두가 똑같은 서버로부터 전송받아 옴에도 불구하고 그림 4에서 설명한 것처럼 매번 별도의 TCP 연결을 맺도록 HTTP 프로토콜은 설계되어 있다.
이와 같은 HTTP 프로토콜 동작 메카니즘에 의해 다음과 같은 문제가 생긴다.
이것은 TCP의 동작 메카니즘에서 발생하는 문제이다. TCP에서 interactive data flow인 경우에 하나의 TCP 연결 속에서 클라이언트와 서버 사이에 서로 주고받고 하는 패킷 교환이 일어나게 된다. 이때 1 바이트의 데이타와 20 바이트의 헤더로 구성되는 매우 작은 TCP 패킷들로서 상호간 동작이 연속적으로 일어난다면 트래픽의 혼잡을 가중시킬 수 있다.
이러한 문제를 해결하기 위한 방법이 Nagle 알고리즘이라 하는 것이다. 이미 전송한 패킷이 있을 때 이 패킷에 대한 수신 성공을 알리는 ack 패킷이 도착하기 전까지는 다른 패킷을 전송하지 않고 버퍼에 대기시키도록 한다. 이렇게 기다리는 동안에 몇 개의 패킷이 전송을 위해 대기하게 될 수 있고, ack가 도착했을 때 이들 전송 대기 패킷들을 하나의 세그먼트로 묶어서 전달하도록 할 수 있다.[5]
이러한 메카니즘은 3.3절의 파이프라인 동작에서 문제를 일으킬 수 있다.[6] 왜냐하면 파이프라인을 통해 연속적으로 요구 메시지가 전달되어야 하는데 Nagle 알고리즘에 의해 즉시 전송되지 못하고 잠깐 대기해야 하는 문제가 생기기 때문이다. 이의 해결책은 Nagle 알고리즘을 사용하지 않는 것으로 TCP 동작을 설정하고 패킷 전송을 하면 된다.
사용자가 웹을 이용할 때 제일 먼저 바라는 것은 자신이 원하는 문서 정보를 보다 빨리 갖고 와서 보고자 하는 것이다. 이것을 가능하게 해주는 것을 성능 향상이라 했을 때, 성능 향상을 위한 방법은 앞서 1절과 2절에서 설명하였던 요소들을 해결하는 방향이라 할 수 있다. 이 절에서 다루고자 하는 내용은 성능 향상을 위한 다양한 방법들을 찾아보고자 하는 것이다.
클라이언트가 HTTP 요구 메시지를 서버에게 전송했을 때 이 메시지를 처리하는 데에 시간이 걸릴 수 있으며, 특히 과부하 상태의 서버나 서버의 느린 하드디스크 속도에 의해 장시간이 걸릴 수 있다. 또한 서버로부터 클라이언트에게 전송된 응답 메시지가 처리될 때 사용자의 화면에 보여주기까지의 처리에 시간이 더 걸릴 수 있으며 종합적인 응답의 지연이 초래될 수 있다.
이와 같이 클라이언트와 서버의 늦은 하드웨어적 처리 속도 때문에 생기는 시간 지연은 더 성능 좋은 CPU, 더 많은 RAM, 보다 빠른 HDD 등과 같이 하드웨어 구성품들의 성능을 향상시키면 해결되는 문제이다.
브라우저가 서버에게 HTML 문서를 처음 요청할 때 설립된 TCP 연결을 서버가 문서를 전송하고 난 후에도 해제시키지 않고 그대로 연결된 상태로 두는 것을 말한다. 이렇게 계속 설립되어 있는 TCP 연결을 이용하여 연속적인 데이타 요청을 할 수 있으며, 각각의 데이타 송수신을 위한 별도의 TCP 연결 설립을 하지 않아도 되므로 프로토콜 성능을 향상시킬 수 있다.
그림 5는 이러한 과정을 나타내는 그림이며, 그림 4에 그려져 있는 연속적인 문서 요청에 대한 각각의 TCP 연결을 설립하는 과정이 그림 5에는 생략되어 있음을 알 수 있다.
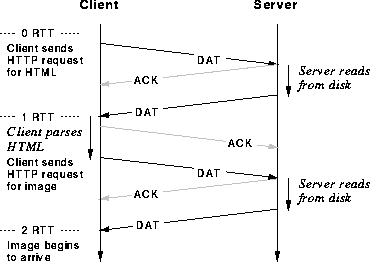
또한 장시간 연결되어 있는 TCP 연결을 통해 2.3절에서 설명된 슬로우 스타트의 문제점도 해소될 수 있다. 그렇다고 해서 무한정 이 연결을 지속시킬 수는 없는 것이므로 클라이언트로부터 아무런 요구가 없이 일정 시간이 지나면 서버가 연결을 해제하는 방식으로 처리할 수 있다.
이러한 향상을 위해서는 클라이언트와 서버 양측에서 HTTP 프로토콜의 동작 메카니즘을 약간 수정해 주어야 한다.
3.2절의 방법을 이용하여 연속적인 화일 송수신의 경우에 각각에 대한 TCP 연결을 개별적으로 설립하는 부담은 줄어들 수 있지만, 개개의 파일을 갖고 오기 위해서는 해당 갯수만큼의 RTT가 걸린다는 문제는 여전히 존재한다.
이 문제를 해결할 수 있는 방안이 파이프라인 방식이다. 이것은 몇 가지 방식으로 표현이 가능하다. 이의 기본적인 전제는 하나의 TCP 연결을 통해 이루어진다는 것인데, 상시 연결 또는 long-lived 연결을 통해 구현할 수 있는 것이다.
그러므로 클라이언트가 보내는 요구 메시지로서 GETALL을 정의하여 HTML 문서 속에 같이 링크되어 있으며 같은 서버에 위치하고 있는 모든 화일들을 하나의 응답 메시지로서 서버가 보내도록 할 수 있다. 이것을 위해 서버는 HTML 문서를 먼저 parsing하여야 하고 그 결과로서 내부에 링크되어 있는 그림 문서들의 위치 정보를 파악하고 서버가 이들을 전송할 수 있도록 한다.
이렇게 하면 개개 화일을 갖고 오기 위해 여러 개의 TCP 연결을 만들어야 했으나 하나의 TCP 연결만 설립하고서 모든 것을 보내라는 하나의 요구 메시지와 해당하는 모든 화일을 묶어서 하나의 응답 메시지로 전송하는 것이 가능하며, 성능의 향상은 명약관화하다.
이 방식은 서버에게 HTML 문서의 파싱이라는 추가적인 부담을 안겨주기는 하지만, 연속적인 그림 화일의 전송 요구 메시지를 미연에 방지할 수 있는 잇점을 만들게 되고, 전체적으로는 성능의 향상을 보장할 수 있는 방법이다.
이것은 연속적인 GET의 경우로서 앞서 전달된 GET의 응답이 클라이언트에게 아직 도착하지 않았음에도 계속 GET을 보내어 응답을 요구하는 것과 논리적으로 똑같은 상황이다.
기존의 HTTP 프로토콜 메카니즘에서는 연속적인 GET을 보낼 수는 있었으나 모두 별개의 TCP 연결을 통해 이루어졌고, 전달된 요구 메시지 갯수만큼의 TCP 연결이 존재했어야 했다. 이것은 그림 6의 왼쪽 그림에 그려져 있는 방식이다.
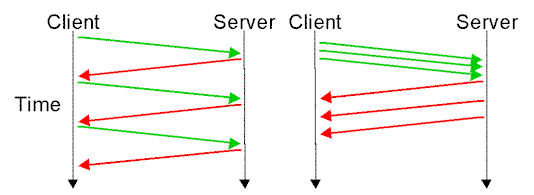
'연속적인 GET' 방법에서 말하고자 하는 것은 하나의 long-lived 연결을 맺어 아직 응답 메시지가 도착하지 않았음에도 연속적인 GET 요구 메시지를 서버에게 전달한다. 이때 서버는 요구 메시지를 수신한 순서대로 응답 메시지를 전달해야 한다. 이에 대한 그림이 위 그림 6의 오른쪽에 있는 것이다.
성능 향상의 방법으로서 프로토콜의 동작을 개선하는 방법도 있으나 전송할 데이타의 양을 줄임으로써도 가능하다. 이러한 방법으로서 쓰일 수 있는 것이 전송할 문서 화일을 압축하고 클라이언트에서 풀어서 사용자에게 보여주는 방법이다.
클라이언트에서 "Accept-Encoding: deflate" 헤더를 요구 메시지에 포함시켜서 보내면 서버에서는 데이타 부분을 deflate 방식으로 압축을 하고 응답 메시지의 사용자 데이타 부분에 실어서 보내게 된다. 이때 응답 메시지에는 "Content-Encoding" 헤더가 추가되고 어떤 방식으로 압축되어 있는지 알려준다. 클라이언트에서는 이 정보를 보고서 원래 데이타로 복원하고 사용자에게 보여준다.
이를 통한 성능의 향상은 약 10 퍼센트대에 이른다. 실험에 따라 14 퍼센트 또는 17 퍼센트의 향상을 보고하고 있기도 하다.
이에 대해서 성능 향상의 관점에서 바라본다면 사용자에게 전송할 데이타의 크기를 줄이는 방식이라 할 수 있다. 이보다도 더욱 주목을 끄는 것은 사용자에게 보다 다양한 그래픽 인터페이스를 제공해줄 수 있고, 홈페이지 제작 및 디자이너에게 그림 화일들의 조작을 통해 실현시킬 수밖에 없었던 표현 형식들을 더욱 손쉽게 다양한 형태로 만들어줄 수 있다는 것이다.
이것을 위한 용도로서 등장한 것이 CSS(Cascading Style Sheets)와 PNG(Portable Network Graphic)라고 하는 것이다. CSS는 문서의 모양을 결정하는 요소들을 별도로 정의하고 HTML 본래 문서와 결합시킴으로써 CSS만 변경시켜도 다양한 형태로 문서의 모습을 바꿀 수 있다. 또한 문서의 표현 양식을 나타내기 위해 쓰이던 각종 아이콘 그림들을 CSS에서 정의하도록 함으로써 그림 화일로 전송해야 했던 것들을 HTML 문서의 태그와 CSS 표현으로서 가능해졌고, 전송의 대상이 되었던 그림들을 전송하지 않아도 됨으로써 상당한 성능의 향상을 기대할 수 있게 되었다.
PNG를 통해서도 어느 정도의 향상을 기대할 수 있는데, 이것 역시 데이타의 크기를 약간 줄여주는 효과를 발휘한다. 특히 gamma information을 PNG 내부에 갖고 있으므로 해서 모든 플랫폼에서 똑같은 그림을 보여줄 수 있도록 하고 있다. GIF와 같은 화일 형식에서는 이러한 기능이 제공되지 않는다. 데이타의 크기에 있어서도 경우에 따라선 GIF보다 PNG의 크기가 큰 때도 있으나 대부분 PNG의 데이타 크기가 약간 작은 것으로 나타나고 있다.
홈페이지 제작에 쓰이는 상당수 아이콘 그림들은 HTML과 CSS1의 조합으로 표현이 가능하다. 아이콘 그림 대신에 HTML과 CSS1의 조합으로 표현하게 되면 다음과 같은 두 가지 잇점이 생긴다.
HTML과 CSS1의 조합으로 표현할 수 없는 그림 아이콘들은 PNG로서 표현할 수도 있는데, 약간의 데이타 양의 감소 효과를 볼 수 있다. 실험 결과에 따르면, 총계 80601 바이트인 14개 그림에 대한 PNG 형식의 그림은 총계 71913 바이트로 표현되고 8688 바이트의 감소 효과를 보였다.
이상과 같은 방법을 통해 총계적인 전송 데이타의 감소와 HTTP 요구 메시지의 감소 효과를 볼 수 있다. 이것은 CPU의 처리 시간 감소, 프로토콜 동작의 단순화, 전송 시간 감소 등과 같은 종합적인 성능의 향상으로 직결된다.
브라우저 측면에서 볼 때 서버에 있는 자료들이 어떤 것인지 미리 알 수 있는 방법은 전혀 없다. 일단 브라우저로 갖고 와서 보아야만 사용자 자신에게 필요한 것인지 아닌지 알 수 있다. 그러므로 불필요한 화일 전송이 일어날 가능성이 매우 높은 것이 사실이다.
이러한 경우에 문서 화일의 일부분만 가져오고 필요한 것일 때 나머지 전부를 가져오도록 할 수 있을 것이다. 또한 그림 화일의 경우에 전체를 가져 오기 전에 그림의 전체 모습만 먼저 보도록 할 수도 있다. 즉, 어느 경우이든 화일의 일부분만 먼저 가져 오도록 하는 기능은 성능 개선의 한 가지 요소가 될 수 있다.
HTTP/1.1을 통해 구현한 성능 향상 기법은 다음과 같은 세 가지로서 구별할 수 있다.[7]
첫 번째의 경우는 HTTP 프로토콜의 동작 방식을 개선한 것이고, 두 번째 경우는 전송할 데이타 양을 줄이는 방식이며, 세 번째 경우에서 CSS는 데이타의 양을 줄이고 또한 전송했어야 할 요구 메시지를 전송하지 않아도 되게끔 하고 있고, 세 번째 경우에서 PNG는 약간의 데이타 양 감소 및 추가적인 기능 제공을 하고 있다.
이와 함께 성능 개선을 위한 구현 관점의 추가 사항도 있다. 2.7절에서 말한 Nagle 알고리즘은 short-lived connections을 기반으로 하는 HTTP/1.0에서는 성능 문제를 야기시키지 않으나, long-lived connections을 기반으로 하는 HTTP/1.1 프로토콜 구조에서는 파이프라인 동작 메카니즘을 이용하고 있어 심각한 문제를 일으키므로 사용하지 않도록 하여야 한다. 이를 위해 TCP_NODELAY 소켓 옵션을 사용하여야 한다.
HTTP/1.1에서는 3.6절의 기능을 위해 If-Range 요구 헤더를 정의하여 데이타의 일부분만 선별적으로 가져 올 수 있게끔 한다. 이것을 이용하여 어떤 오브젝트 화일의 메타 데이타만 가져와서 공통적인 데이타 형식에 대해 알 수 있도록 한다.
HTTP/1.1 프로토콜 설계에 있어서 4장에서 언급한 내용들의 종합적인 성능 향상 효과는 눈에 두드러지게 나타나고 있다. 동시 연결을 통해 여러 개의 데이타 화일을 가져오던 HTTP/1.0 모델에 비해 송수신하는 패킷의 갯수를 기준으로 하면 적어도 2배, 종종 그 이상의 비율로 감소시켜 주고, RTT 시간의 감소 효과는 패킷 갯수 감소에 비하면 덜 하긴 하지만 그래도 주목할 만큼의 감소 효과를 보여 주었으며, HTTP/1.1의 의한 bandwidth 감소는 각종 성능 향상 요소들의 활용 여부에 따라 2퍼센트에서 35퍼센트 정도의 차이를 보였고, 이에는 캐시의 활용 여부도 매우 중요한 역할을 차지한다.[7]
이상과 같은 HTTP/1.1 모델은 인터넷 상에서의 트래픽 특성에도 영향을 미치는 요소이다. 현재의 인터넷에서 활용되는 웹 트래픽의 증가 속도는 경이로울 정도이며 이제는 FTP와 쌍벽을 이루고 있는 상황이므로 새롭게 변화될 HTTP/1.1에 의한 웹 트래픽은 인터넷 상의 트래픽 특성에조차 영향을 미치게 된다. 평균적인 패킷의 크기가 커지고 TCP 연결당 송수신되는 패킷의 갯수가 많아지며 TCP 연결 설립과 해제를 위해 쓰이던 패킷이 대부분 사라지게 된다.
웹의 기반 통신 구조가 변화되면서 전반적인 통신망 환경의 개선에도 기여하게 되며 사용자들이 직접적으로 느끼는 향상도 느끼게 되어 확대 재생산의 초석이 되게 된다.