 WAKANO Search EngineWAKANO Search Engine
1991년에 등장한 World Wide Web은 인터넷을 기반으로 하는 Hypermedia 정보로서 네트워크의 활용을 가속화 시켰으며, 인터넷의 역사를 한순간에 바꾼 획기적인 사건으로 기억된다. 그러나 이 후 늘어나는 웹 페이지는 미국과 캐나다만에서 이미 4천만 페이지에 이르고 있으며 국내에서도 약 10만페이지 이상이 존재한다고 추정한다. 이러한 정보의 홍수속에서 사용자들은 원하는 정보를 어떻게 찾을 것인가에 대한 문제에 봉착하게 되었고, 이러한 해결책으로 제시된 것이 검색엔진이다.
국내에서도 Kor-seek로 시작된 검색엔진의 역사는 많은 다른 검색엔진을 개발하는 시발점이 되었고, 다양한 스타일을 가진 검색엔진들이 꾸준히 개발되고 있다는 사실은 상당히 고무적인 일이라고 할 수 있다. 그러나 대부분의 검색엔진들이 로봇 에이전트를 이용한 단어별 검색엔진의 개발에 촛점을 맞추고 있으며, 브라우저에 의한 네트워크의 부하보다도 이러한 로봇 에이전트에 의한 네트워크 과부하가 심각한 문제로 대두되고 있다.
클라이언트-서버간의 공조를 통한 정보 획득 방법의 시조인 Harvest는 좋은 이론을 제시하고 있으며, 와카노 역시 이러한 네트워크의 과부하를 억제하고 정보의 신뢰도를 높이기 위한 정책을 기본으로 출발하게 되었다. 2장에서는 개발목적을 소개하고, 3장에서는 개발 시기와 환경에 대해서, 4장에서는 전체 시스템 구성을, 5장에서는 RTIS을 통한 효율적인 정보수집에 대해서, 마지막으로 6장에서는 개선되어야 될 점들을 제시함으로서 본 원고를 마친다.
와카노는 웹 공간을 무분별하게 돌아다니는 로봇 에이전트의 역효과를 조금이나마 덜고자 고안되었다. 대규모 검색엔진의 경우 자신들의 고유한 로봇 에이전트를 수행한다. 그러나 이 로봇 에이전트가 동작하는 방식에 대한 여러가지 알고리즘들이 존재하기는 하지만, 대부분 우연성에 의존하는 방식이다. 즉 새롭게 작성된 홈페이지나 변경된 홈페이지에 대하여 어떤 방법으로 수집하는냐는 문제가 대두된다. 누군가가 새로운 홈페이지를 작성하였을 경우 로봇 에이전트가 자신의 홈페이지를 가져가져 인덱싱처리를 해줄지에 대해서 다분히 수동적인 입장을 취할 수 밖에 없다. 그래서 많은 사용자들이 웹 디렉토리 서비스에 자신의 홈페이지를 등록한다. 대표적인 경우가 Yahoo의 형태이다.
그러나 이 방법 또한 효율적이지 못하다. 사실 검색엔진을 사용하는 가장 큰 이유중에 하나가 필요한 정보를 찾는 실마리가 되는 단어(우리는 여기서 Keyword라는 표현을 쓴다)를 알고 있을때이다. 웹 디렉토리 형태의 단점은 많은 글을 통해 지적되어 왔듯이 범위의 한계와 디렉토리를 유지하기 위한 관리자의 부담을 들수 있다. 물론 자동으로 등록되는 Form을 제시할 수도 있겠지만, 이경우 잘못된 URL에 대한 처리는 전적으로 서버의 몫이다.
위의 설명들은 단순히 사용자 입장에서의 불편한 점이다. 그러나 더 큰 문제는 로봇 에이전트가 네트워크를 과부하 상태로 만든다는 사실이다. 대부분의 검색엔진들은 보다 빠르게 정보를 추출하기 위해서 병렬적으로 수행시키는 방법을 사용한다. 즉 여러개의 로봇 에이전트를 동시에 수행시키게 되고 이때 네트워크는 일관되게 높은 대역폭을 가지게 되어 같은 시간대의 다른 사용자는 느려진 네트워크 속도를 감수해야 된다. 이렇게 로봇을 수행시키는 서버쪽에서는 로봇 배제를 위한 표준안과는 무관하게 시스템에 부하를 주게 된다. 이에 반해 로봇의 방문을 받는 웹 서버의 경우 로봇 배제를 위한 표준안이 효과를 볼 수 있다. 그러나 이것도 역시 웹 서버 운영자의 마인드에 달린 것이다. 결국 로봇 에이전트의 사용을 얼마나 줄이느냐는 것이 가장 현실적인 방법이 된다. 로봇 에이전트의 사용을 억제하면서 효과적인 정보 수집방법에 대한 연구로 시작한 것이 와카노의 개발 목적이다.
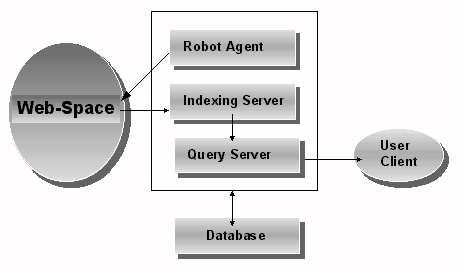
와카노 전체구조는 크게 3부분으로 나누어 진다. 각 서버는 독립된 시스템에서 수행되며 최종결과는 Query 서버를 통해서 실제 사용자에게 서비스된다. 또한 분산 시스템 기법을 도입하였으며 초기에
로봇 에이전트는 Pentium기반의 PC, Windows/NT환경에서 JDK 1.0.2를 사용하였으며, 인덱싱
서버는 Sun Sparc20, Solaris 2.4 환경에서 C를 사용하였고, Query 서버는 TGStation,
SunOS 4.1.1 환경에서 C를 사용하였다. 그러나 현재는 Query, RTIS 서버를 UltraSparc-1을 사용하고
있다. 각각의 시스템은 수행될 작업의 부하에 따라서 분산시켜 두었으며, 가장 많은 부하를 요구하는 인덱싱 작업을 다른 작업보다 높은 성능의 시스템에 할당하였다. 이렇게 분산된 시스템에서
수행된 작업들은 모두 Query 서버로 옮겨지고, 최종 사용자는 단순히 Query 서버에서 모든
검색을 수행하게 된다. 다음 그림은 전체 시스템 구성도를 보여주고 있다.
에이전트는 "분산 환경에서 작업을 수행하는 지적인 특성을 갖는 응용 프로그램"으로 정의된다. 각 연구 분야에 따라 다양한 의미로 해석이 가능하지만, 여기서는 보조 에이전트(Assistant Agent)의 한 분야인 로봇 에이전트에 대해서만 고찰한다.
형태소 분석은 한국어 어절을 형태소라는 의미적 최소 단위로 분리하는 작업을 말한다. 한글 문서는 구조적인 특성상 띄어쓰기의 오류및 조사활용에 대한 변화가 다양하기 때문에 의미있는 단어를 찾아내기 위해서 형태소 분석은 필수적인 요소라 할 수 있다. 인덱싱 서버의 역활은 형태소 분석과 검색을 위한 스크립트의 생성을 목적으로 수행된다.
실제로 사용자가 인터넷을 통해서 원하는 문서에 대한 검색을 처리하는 부분으로서 실제로 사용자가 느끼는 검색엔진의 속도가 되기 때문에 질의어 처리부는 수행절차가 간단하고 프로그램의 크기가 작아야 한다.
우선 사용자는 URL Sender Application이나 URL Sender Applet을 이용하여 RTIS 서버에 서비스를 요청한다. RTIS 서버는 사용자의 반응이 오는 즉시 로봇 에이전트에게 사용자가 요구한 URL로 문서를 가져오도록 지시한다. 이 때 RTIS 서버는 로봇 에이전트가 문서를 가져올때 까지 대기하고 있다가 제대로 HTML문서를 가져왔는지 확인한다. 어떠한 문제로 인하여(서버쪽이든, 클라이언트쪽이든) 제대로 HTML문서를 가져오지 못한 경우 서비스를 요청한 사용자에게 인덱싱 서비스가 실패했다는 Email을 보내게 된다.
무사히 HTML문서를 가져왔을 경우 RTIS 서버는 가져온 문서를 인덱싱 서버에게 보내주게 되고, 이때 인덱싱 서버는 받은 HTML문서에 대해서 인덱싱을 하게 된다. 정상적으로 인덱싱이 끝나면 RTIS 서버는 다시 서비스를 요청한 사용자에게 인덱싱 서비스가 성공적으로 수행되었다는 Email을 보내게 된다. 이렇게 인덱싱된 결과는 다시 Query 서버에게 보내지게 되고, 사용자는 와카노 홈페이지에서 새롭게 인덱싱된 데이터도 함께 서비스받게 된다.
URL Receiver는 RTIS 서버에서 사용자 요청을 처리하기 위한 서버 프로그램이다. 이것은 자바로 구현되었으며, RTIS 서버로는 Sun UltraSparc-1, Solaris 2.5환경에서 운영되고 있다. 모든 처리를 실시간으로 하기 위해서 URL Receiver는 사용자의 요구 수만큼 Thread를 생성시켜서 동작한다.
TCP/IP BSD Socket을 이용하고 있으며, Email로 사용자에게 확인메일을 보내기 위한 자바 Mail Sender
프로그램을 포함하고 있다. 다음 그림은 RTIS 시스템 구성도를 보여준다.
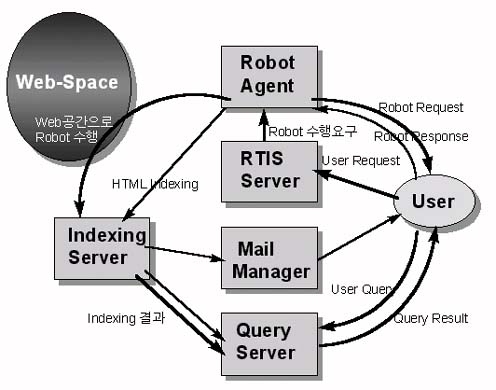
URL Receiver를 세부적으로 구분하면 Thread Manager, Single Robot Agent, Email Manager로 구분할 수 있다. 그림에서 보는 바와 같이 RTIS 서버에서 Thread Manager를 수행하는데 새로운 사용자가 연결될 때마다 새로운 Thread를 생성시킨다. 생성된 Thread는 독립된 역활을 하는데, Single Robot Agent와 스크립트 생성등이 이 Thread를 통해서 수행된다. 로봇 에이전트의 수행결과는 인덱싱 서버에게 보내어 지게 되는데 이때 최종 성공/실패 여부를 Email Manager에게 보내준다. Email Manager는 사용자에게 일정한 형식으로 이루어진 메일을 보내고 관리한다.
정리하자면 사용자가 URL Sender Application이나 URL Sender Applet을 사용할 때 마다 URL Receiver는 하나의 Thread가 생성되며, 이 Thread에서는 사용자가 요구하는 URL로 로봇 에이전트를 보내게 된다. 로봇 에이전트가 가져온 HTML문서에 대한 반응으로 인덱싱 서버에게 HTML문서를 보내고 인덱싱을 요구한다. 정상적으로 HTML문서를 로봇 에이전트가 가져오기 못할 경우 실패 mail을 송신하고, 문제가 없으면 인덱싱이 끝난후에 사용자에게 성공 mail을 송신한다. 이러한 실시간 서비스를 위해서 가장 중요한 부분은 인덱싱 서버의 수행속도이다. 인덱싱과정이 수행이 느려지면 여러개의 Thread에 의해 생성된 Process의 수가 많아지게 되고, 결국 전체 시스템의 성능을 저하시키는 결과를 초래한다. 따라서 와카노에서는 인덱싱의 수행 속도의 대부분이 명사사전 검색에서 지연되기 때문에 현재는 한글 초성을 분리해서 색인화일을 유지하는 방법을 사용하고 있다.
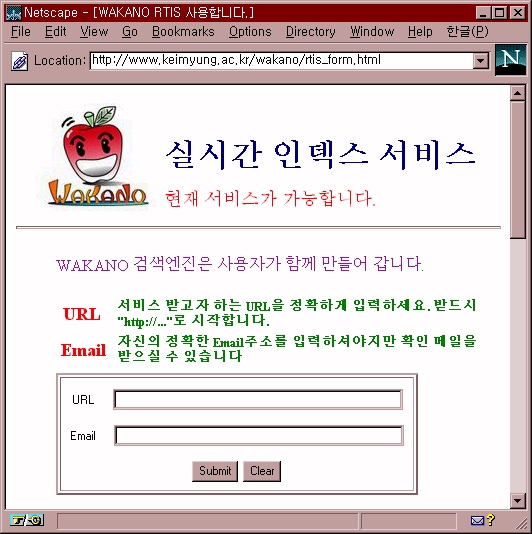
다음 그림은 실제로 와카노에서 서비스되는 RTIS 중에서 URL Sender Applet이 수행되어 사용자에게 입력을 요구하는 화면이다.
우선 인덱싱 서버의 부하를 더 줄여야 한다. 초성에 의한 분류법은 한계가 있다. 따라서 초성, 중성, 종성을 각각의 색인으로 유지할 수 있어야 하며, 전체적인 사전 검색은 B+ 트리형태로 변경되어야 한다. 검색 가능한 한글의 처리능력은 명사사전에 달려있으며, 11월 중으로 15만 단어로 업그레이드 할 예정이다.
유의어에 대한 처리가 확장되어야 한다. 영한 사전을 통한 유의어방식에서 탈피하여 시소러스를 사용하여 의미단계에서의 유의어 처리가 필요하다. 현재 공개된 시소러스 사전의 입수가 어렵다는 것이 큰 문제다.
Boolean 연산에서 OR 연산보다 AND 연산이 수행속도를 저하시킨다.(필자의 주관이지만) 그러나 무엇보다도 시급히 개발되어야 할 부분은 구절검색이다. 아직까지 제대로 구절검색이 가능한 국내 검색엔진은 없다. 본인이 11월 이후 집중적으로 연구하고자 하는 부분도 역시 이 부분이 될 것이다.
URL Sender 프로그램의 GUI 환경과 복수개 URL에 대한 처리능력이 추가되어야 한다. 사용자는 Windows/Motif등에서 GUI를 통해 보다 간단하게 작업을 수행할 수 있도록 할 것이다. 아직은 모든 것이 초기 버전 그대로 이지만 곧 지속적으로 업그레이드를 계속할 예정이며, 많은 네티즌은 와카노에 기대를 걸어도 좋을 것이다.