 까치네 로봇의 원리와 서비스 형태
1. 서론
인터넷은 많은 정보로 가득찬 바다와 같다[5]. 이미 미국에서는 수많은 웹 정보를 모아 자동 저장을 하고 이 정보들을 분류해 서비스해주는 기법에 대한 많은 연구가 있었고 이를 바탕으로 하여 서 비스 하고 있는 사이트들 도 많이 생겨났다[10]. 국내에도 인터넷과 웹의 바람이 불면서 웹사이트와 홈페이지의 수는 기하 급수적으로 늘어나고 있으 며 국내 인터넷상에는 약 40만개 이상의 HTML 파일들이 존재한다[1]. 그러나 아쉽게도 한글 검 색을 지원해주는 정보검색 사이트는 아직까지 적은 수이며, 로봇 또는 스파이더라 불리는 정보수집 프로그램을 이용한 사이트는 훨씬 더 적다[2].
이에 까치네는 비교적 한정된 영역에서
도메인이라는 구분 자를 이용해 로봇을 구현하였다.
이렇게 구현된 로봇과 일반적으로 알려진 기본적인 알고리즘을
이용한 로봇의 성능을 살펴 보도록 하고 이 구현된 로봇을 통한
서비스들을 알아보도록 한다.
2. 로봇의 기본 알고리즘
로봇이나 스파이더는 원하는 정보를 얻기 위해 문서들을 검색하고, 참조되 는 문서들을 재귀적으로 검색하면서 웹의 하이퍼텍스트 구조를 자동적으로 추적하여 정보를 저장해주는 프로그램이다 [3]. 이러한 문서들을 재귀적으로 검색하기 위해서는 웹의 프로토콜인 HTTP를 준수하는 프로그램이 어야만 한다.
2.1 HTTP 프로토콜
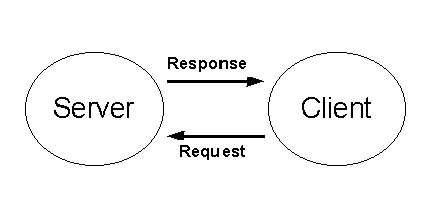
HTTP는 OSI 7 Layer에 의하면 Application 계층에 속하는 프로토콜로 [그림1]에서 보인 것 과 같 이 아주 간단한 프로토콜이다[9]. 클라이언트로부터의 GET, HEAD, POST 등의 요구에 따라 서버는 해당되는 텍스트나 정보들을 클라이언트에게 전달하는 방식으로 되어 있다.
간단한 예를 들어 보자. 만일 자신이 원하는 URL이
http://www.taegu.ac.kr/index.html이라면
www.taegu.ac.kr이라는 서버의 알려진 WWW 포트번호(80번)로 접속을 한 다음
"GET /index.html\n\r"을
request하면 해당 문서인 index.html을 response한다[11].
2.2 기본적인 로봇 알고리즘
위에서 설명된 바와 같이 HTTP를 이용하여 인터넷상의 정보를 모으게
되는 간단한 로봇은 URL
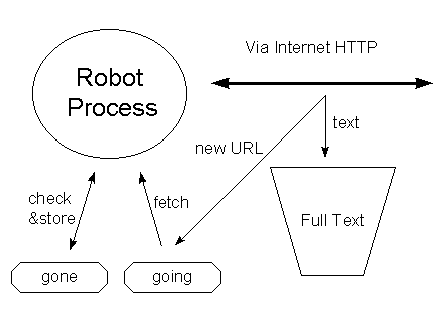
을 기준으로 [그림2]와 같은 알고리즘을 사용한다[2].
[그림2]와 [표1]에서 보인 바와 같이 다녀온 URL과 앞으로 검색해야 할 사이트들을 저장하는 going, gone 시스템과 URL을 검색해서 얻어진 Full Text를 저장하는 방법에서 각 로봇들은 많은 차이를 가지게 된 다.
2.3 기본적인 로봇의 응용
이 로봇을 이용하면 보통 다음과 같은 서비스들을 할 수 있다. 이에 대한 상세한 설명이나 실 예는 4장에서 자세히 다룬다.
- Error Detect
- Search Engine
- Link Service
- What's NEW Report
|
1. 국내 리스트페이지 등에 접속하여 자신이 방문하여야할 것을 GOING에 저장 2. GOING에서 URL을 하나 꺼내 오고 이 URL을 GOING에서 삭제한 다. 3. GONE를 통해 다녀온 URL인지를 확인한다 4. 다녀온 URL이면 2번으로 간다. 5. 다녀오지 않은 URL이면 이 URL을 GONE에 저장한다. 6. URL 방문하여 새로운 링크가 있으면 GOING에 추가 저장한 다. 7. 위 6번에서 얻어진 본문을 분석하고 이 TEXT를 저장해 둔다. 8. GOING이 NULL일 때까지 2번부터 반복 수행한다 |
*주 - GOING : 앞으로 방문해야할 URL의 저장 시스템
GONE : 다녀온 URL의 저장 시스템
3. 도메인을 이용한 로봇
3.1 기본적인 로봇알고리즘의 문제점
2.2절에서 언급한 간단한 알고리즘에 대한 로봇의 문제점은 다음과 같은 몇 가지로 분류할 수 있 다.
- 상대 시스템에 과다한 부하를 부여
위 알고리즘을 그대로 적용한다면 going저장 시스템에 일련의 사이트 순
으로 다음에 접근해야할
URL을 저장하는 방식이 된다. 이 URL을 별 가공 없이 재귀적으로 따라 움직였을 때 한 서버
에 대해 여러 로봇 프로세
스들이 연속적으로 접근하게 되는 Rapid Fire가 발생하게 된다[7]. 이로 인해 해당 서버의 네트웍
이나 CPU에는 과다한 부
하가 걸리게 되고 이 서버를 이용하는 사람들은 상대적으로 낮은 대역 폭과 저 성능의
서비스를 지원 받게 된
다.
- 로봇 프로세서의 동작 오류
일반적으로 로봇의 성능을 증대시키기 위해서는, 병렬적인 방법으로 여러
개의 로봇 프로세스를 동
시에 실행하게 된다[7]. 각 프로그램이 going 이나 gone 등의 저장 시스템을 참조하므로 트랜젝
션등이 발생할 경우 로봇은
다녀온 사이트를 반복해서 다녀오는 등의 심각한 오류가 발생할 수 있게된다.[7] 또한 결과로 얻
어지는 Full Text를 저장
하는 OUT시스템도 위와 같은 URL정보가 여러 번 저장되는 등의 위와 같은 문제점이 발생하게
된다.
- gone의 Check시 로봇 성능 저하
어떤 저장 시스템을 사용하던지에 관계없이 많은 대상을 검색하려면 더 많
은 시간이 걸린다. 로봇은
한 번 다녀온 URL의 페이지는 다시 방문하는 일이 없어야 하므로 다녀온 페이지인지의 여부를
저장 시스템을 통해 항상
확인 하여야 한다[7]. 그러나 동작처음에 로봇이 수만개의 페이지를 모았을 때의 상태에 비해
수십만개의 페이지를 이미
다녀온 경우라면, 다녀온 URL을 저장하고 있는 gone의 대상이 급격이 증가하였으므로 이로
인하여 성능이 저하된
다.
- 인덱싱 결과의 관리문제
로봇의 결과로 생기는 인덱싱하기 직전의 텍스트는 약 19만 건의 페이지를 모았을 경우 1G가 넘는 양이다. 이를 하나의 저장시스템화 한다는 것은 것은 인덱싱을 하거나 저장시스템을 관리 하는데 많은 문제가 따른 다.
3.2 도메인을 이용한 로봇의 원리
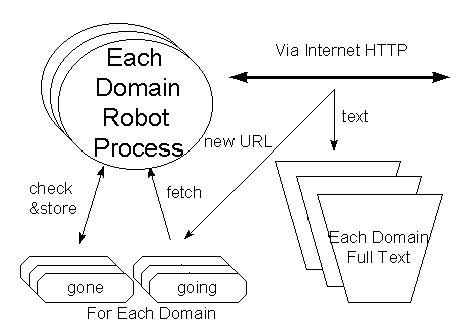
까치네에서 제안하는 로봇은 도메인이라는 특별한 구분 자를 이용해 문서 들을 검색한다. 이 로봇의 알고리즘과 각 저장시스템을 구현하는 방법을 보면 [그림3]과 같다.
이 알고리즘을 [표2]에 정리하였다.
|
1. 국내 리스트페이지 등에 접속하여 자신이 방문하여야할 곳을 도메인별 GOING에 저장 2. 도메인별로 로봇프로세스 수행 1) D-GOING 에서 URL하나를 꺼내오고 해당 URL삭제 2) D-GONE를 통해 다녀온 URL인지 확인한다. 3) 다녀온 URL이면 1)부터 수행한다. 4) D-GONE에 URL을 기록한다 5) URL 방문, 새로운 링크를 D-GOING에 추가 6) 위 5)에서 얻어진 본문을 분석하고 TEXT를 도메인별로 저 장. 7) D-GOING이 NULL일 때까지 1)부터 반복 수행 3. 모든 도메인이 수행되면 종료한다. |
이전의 시스템과 다른 점이 있다면 각 gone과 going 의 시스템을 도메인 별로 분류하여 저장하고 각 도메인 별로 가벼운 저장 시스템을 이용해 다녀온 사이트인지의 여부를 확인하도록 되어 있 다는 것과 결과 저장 시스 템도 도메인별로 분류하여 적절한 크기의 나누어진 저장시스템으로 만들어진다는 것이다. 기존의 알고리즘에서 문제로 작 용했던 병렬처리로 인한 혼선도 각기 하나씩의 도메인을 담당하는 로봇 프로세스가 각각의 gone, going 저장 시스템, 하나 의 out저장 시스템을 관리하므로 문제를 해결 할 수 있다. 또한 로봇이 다녀온 URL의 수가 많아 질수록 gone, going의 크 기가 방대해졌던 문제도 각 도메인별로 정리하므로 그 방문URL이 국내 도메인의 사정상 2000~3000건 이상을 넘지 않았 다.
가장 큰 장점중 하나는 로봇프로세스가 도메인별로 동작하므로 여러 프로 세스에 의해 한 도메인 혹 은 서버가 attack당하는 일은 없으며 상대적으로 해당 서버를 이용하는 사용자는 기존의 알고리 즘에 높은 대역 폭을 보장 받을 수 있다.
*주) D-GOING : 각 도메인별로 방문해야할 URL의 저장 시스템
D-GONE : 각 도메인별로 방문한 URL의 저장 시스템
3.3 성능의 향상
위에서 말한 바와 같이 몇 가지 문제들을 해결함으로써 다음에서 보여지 는 것과 같은 성능의 향상 을 가져 왔다.
- gone Check 루틴의 원활한 동작
: 하나의 저장시스템을 통해 이루어지던 gone Check 루틴을 Domain 수만 큼 - 약 800개로 나누어 실행하게 되므로 해서 약 800배의 성능향상을 가져왔다.
- 유동적인 종합 저장시스템
: 여러프로세스에 의해 열리고 닫히는 부분을 하나의 단일 프로세서에서 하 나의 저장시스템을 열어 두고 계속 I/O를 수행함으로 저장시스템을 Open, Close, Lock 등의 오버로드를 줄일 수 있었다.
단위 : pages
|
|
1시간 |
2시간 |
1일 |
성능비 |
|
일반알고리즘 |
3130 |
5500 |
68,000 |
1 |
|
도메인을 이용한 로봇 |
4350 |
7950 |
85,600 |
1.25 |
종합적으로 볼 때 [표3]에서 보인바와 같이 약 25%의 성능향상이 있었 다.
(주) 이 성능 시험은 펜티엄75/16M Ram/2G SCSI/T1, LINUX OS에서 시
험된 것임.
4. 로봇의 응용 서비스
까치네에서는 이와 같은 로봇을 이용해 실제 서비스를 하고 있다. 지난 1월
10일에 이어 까치네 2의
로봇을 응용한 기능들을 소개한다.
4.1 싱싱나라(What's NEW)
자신의 홈페이지가 만들어지면 이를 여러 방법으로 홍보하고 싶어 한다. 또 자신의 홈페이지가 변경 되었다면 또 이를 알리는 것이 바람직하다. 그러나 사실 지금의 인터넷에서는 이러한 채널이 마 땅하지 않다.
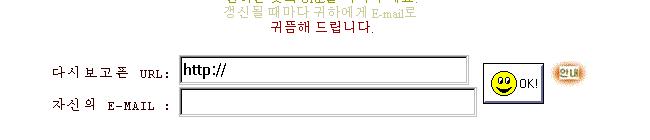
만약 자신의 홈페이지에 SUBSCRIBE기능을 만들고 여기에 가입된 사람 들에게 자신의 홈페이지가 변경될 때 마다 알려준다면 약간은 흥미 있는 서비스가 될 것이다.
이부분도 로봇이 해 낼 수 있는 일중하나이다. 까치네는 URL과 EMAIL이 두 개의 인자로 데이터베 이스를 구성하여 일정시간마다 URL에 접근하여 - 이때는 부하가 적은 HEAD방법으로 접근한 다 - 수정여부를 판단한다. 만일 수정되었다면 해당 URL에 가입된 사용자(EMAIL)들에게 홈페이지가 변경되었다는 메일을 보내준다.
4.2 링크된 URL찾기
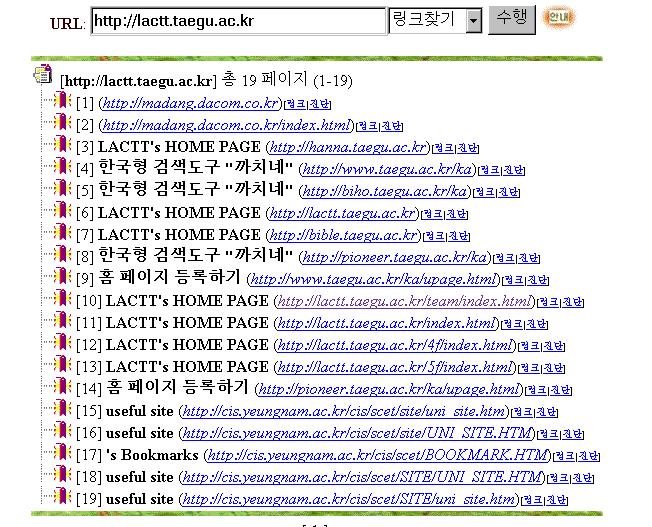
로봇의 알고리즘은 처음의 시작페이지의 링크를 따라 인터넷을 순회하도
록 되어 있다. 그러므로 자
신의 홈페이지에 까치 로봇이 방문한다면 자신의 홈페이지는 인터넷의 어떤 홈페이지에 링크 되
어 있는 것이다. 이런 원
리를 역으로 이용하여 인터넷 상에서 자신의 홈페이지를 링크하고 있는 페이지들을 보여주는
흥미로운 서비스를 제공한
다.
4.3 URL 점검
로봇이 주는 또 하나의 혜택중하나는 바로 이런 에러의 체크루틴이다. 즉 사람이 만든 페이지이므로 에러가 있을수 있고 또 자신의 홈페이지가 링크하고 있는 페이지가 서비스를 중단하거나 URL을 바꾸었을 경우 404NOT Foud 등의 에러를 내게 되는데 로봇은 이런 모든 페이지들을 방문하고 점검하기 때문에 그 링크 된 페이지들의 상태를 기 억 할 수 있다. 그러므로 이 자료들을 잘 인덱싱한다면 사용자들의 페이지가 가지로 있는 링크부 분의 에러를 검줄하여 진 단하는 서비스를 제공 할 수 있다.
4.4 검색 서비스
로봇을 돌리는 가장 큰 이유중 하나가 바로 이 검색을 위한 것이다. 알려진
바대로 검색에나 또는 디
렉토리별로 자신의 원하는 정보의 URL을 얻을 수 있다.
4.4.1 까치네 사전
|
한글 색인 용어 사전 |
기본적인 색인용어를 포함하고 있는 명사위주의 용어사전과 한글 자소 예) 정보 , 검색 , 분석 , 한글 , 가 , 네 , 프 , |
|
한글 불용어 사전 |
신용어 처리와 외래어 처리를 위한 한글 불용어 사전, 주로 조사와 동 사, 연결어 등이 포함되어 있다. 예) 은 , 는 , 이, 가 , 그리고 , 그래서 , 하였습니다 , 아니라는 |
|
영문 불용어 사전 |
영문 색인 용어처리를 위한 영문 불용어 사전, 사용빈도는 높지만 중 요하지 않은 약 200여개의 단어를 포함 예) the , is , this , that , I , case , switch |
까치네 색인 생성기의 구조는 입력 문자열 중에서 색인용어 사전에 등록된
단어들을 추출하여 색인
목록을 생성하는 방법을 취하고 있다.
4.4.2 어휘분석과정
어휘분석과정을 도표로 나타내면 다음과 같다
|
1. |
로봇이 모아온 문서상에서 문자열을 추출 및 문헌 식별자 할당 |
|
입력 문자열의 끝 문자까지 2와 3의 과정을 반복한 다 |
|
|
2. |
입력 문자열중 색인용어 사전에 등록된 단어를 추출하 여 1차 색인용어를 생성한 다. |
|
3. |
1차 색인용어의 나머지 문자열에 대해 불용어 검사를 수행한 다. |
|
4. |
생성된 색인용어를 색인목록파일에 등록한 다. |
4.4.3. 문자열 추출 및 문헌 식별자 할당
문서상에서 문자열 추출하기 위해서는 문자열 구분자를 정의해야 하는데 일반적으로 문서상에 나오 는 문자들을 분류하면 다음과 같다.
|
숫자 |
일반적으로 숫자는 좋은 색인용어를 만들지 못하므로 종종 색인에 포함시 키지 않지만 몇몇 문헌에 서는 중요한 의미를 가질 수 있다. 예를 들면 전자공학에서 사용되는 문헌에서 보 면 "74LS288", "4054" 와 같이 반도체 이름을 구성하는 요소로 사용되고 항공기에 관련된 문헌에서 는 "F15", "F16"과 같 은 숫자들이 문자열에 포함이 되어야 한다 |
|
하이픈 |
단어 속에 하이픈이 있는 경우 하이픈으로 연결된 단어를 하나의 토큰으로 취급할 것인지 하이픈에 의해서 단어를 분리하여 취급할 것인지를 결정해야한다. 만일 "ground-controlled","ground controlled"라는 단어들이 있을 때 하이픈을 무시한다면 이 단어들은 동일하게 인식이 될 것이다. 일관성 있게 용어를 사용 할 수는 있지만 하이픈으 로 연결된 절의 특수한 의미는 잃어버리게 된다. |
|
기타 구두점 |
하이픈과 마찬가지로 마침표는 "index.exe"과 같이 컴퓨터 시스템의 파일이름의 한 부분으로 이용된다 그리고 슬래쉬(/)는 "OS/2"와 같이 한 이름을 구성하는데 사용된다. 그리 고 언더스코어 문자(_)는 "m_data_s"와 같이 종종 프로그램밍 언어에서 사용된다. |
|
영문 대(소)문자 |
영어 문자의 대소문자 구분은 색인형태에서 중요하게 생각하지 않고 있다. 그래서 정보검색의 어휘 분석기는 모든 영문자를 대문자 또는 소문자 중의 하나로 통일해서 처리를 한다. 그러나 프로그 래밍 언어에서는 대문자와 소문자를 구분하여 사용하므로 원시 코드에 대한 정보검색 시스템에서는 색인용어 생성시 대(소) 문자의 구별을 하는 것이 좋다. |
|
한글 |
한글로 이루어진 단어들은 숫자를 제외해서 위에서 얘기한 문제점들이 발 생할 확률이 적으므로 한 글로 이루어진 단어들을 하나의 토큰으로 처리를 한다. |
까치네 색인용어 생성기에서는 문자열의 시작은 숫자로 하지 않
으면서 공백이 아닌 한글
또는 영문과 숫자의 문자들의 조합을 하나의 문자열로 간주하고 모든 구두점과 공백, 제어 문자
는 문자열 구별자로 취급
하는 것을 원칙으로 하였다. 그리고 이러한 문자열 추줄 과정에서 각 문헌에 대한 식별자를 할
당하고 색인 용어 목록 파
일 등록시에 이용한다.
4.4.4. 색인 목록 파일 생성
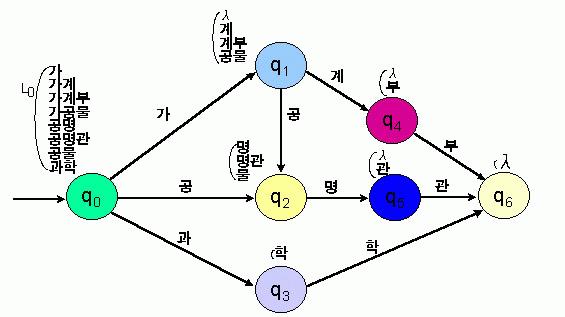
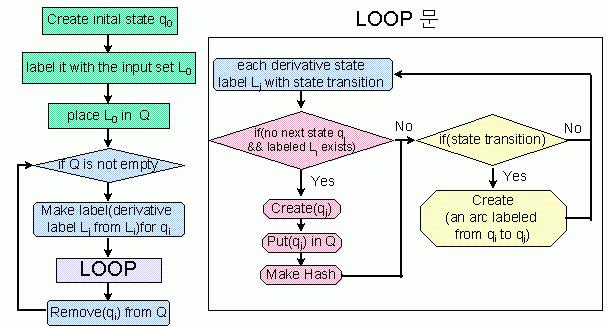
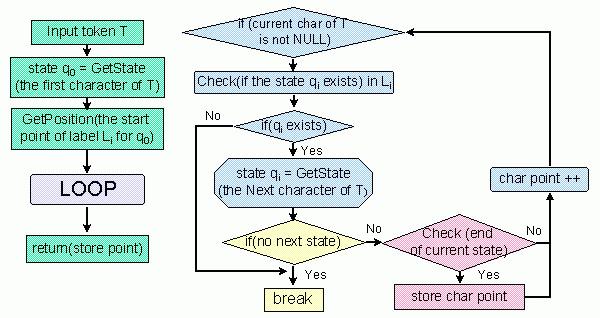
입력문자열을 색인용어 사전과 비교 하기 위하여 사전을 유한오토
마타(Deterministic Finite
Automata: DFAs)를 이용하여 유한 상태 집합을 생성한 후 입력 문자열에 대해 검사를 수행한다.
입력 문자열의 첫 문자
를 초기 상태로 두고 문자 포인터를 증가시키면서 다음 상태의 유·무와 그 상태로 끝나는 단어
가 존재하는지 검사를 한
다. 만일 임의의 상태에서 끝나는 색인용어가 존재한다면 그 상태의 문자 포인터를 저장을 하
게되고 다음 상태가 존재
하지 않을 경우에 저장된 문자 포인터까지의 문자를 1차 색인용어로 등록한다. 등록된 문자이후
의 문자열에 대해 불용어
검사를 수행한 후 불용어가 아니라면 다시 검사를 수행한다. 이와 같은 과정을 반복하여 생성된
색인용어를 색인용어 목
록파일에 등록을 한다. 이와 같은 과정을 통해 사전에 등록된 단어들로 이루어진 복합명사를 처
리할 수 있으며 불용어의
검사를 통해 신용어와 외래어 또한 처리할 수가 있다. 까치네 로봇은 도메인 별로
문서를 수집하여 저장하
는 방식을 취함으로 이러한 색인 목록 파일 생성시에도 도메인 별로 병렬로 처리하여 색인목록
파일 생성시간을 단축하고
있다.
- 데이터 베이스화 과정
|
1. |
전체 색인 목록파일 생성 |
|
2. |
영문 알파벳 및 한글어 순서로 sorting |
|
3. |
같은 문서 참조번호를 갖고 있는 중복 색인 용 어에 대한 빈도수 계산 |
|
4. |
빈도수에 따른 영문 알파벳 및 한글어 순서로 sorting |
|
5. |
전체 문서에 대한 색인 용어 빈도수 계산 및 데이터베이스 파일 생성 |
- 유한 상태 생성 예
- 유한 상태 생성 알고리즘
- 한글 어휘분석기 구현 알고리즘
4.4.5 데이터 베이스 파일의 구조
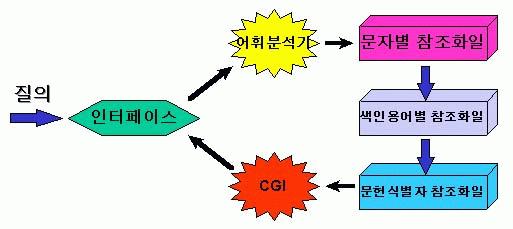
까치네 색인생성기에서 사용하는 데이터 베이스 파일 구조는 역파일 구조
를 사용하고 3개의 파일로
구성된다.
※ 파일의 역활
|
1. 문자별 참조 파일 |
색인용어별 참조파일에 대해서 각 시작 문자별 시작 포 인터 값을 저장하고 있는 파일 |
|
2. 색인 용어별 참조 파일 |
실제 색인 용어에대한 문헌 식별자 참조 파일의 시작 포인터 값을 저장하고 있 는 파일 |
|
3. 문헌 식별자 참조 파일 |
색인 용어에 대한 참조 문헌 식별자 값을 저장하고 있 는 파일 |
※ 파일 구조
|
1. 문자별 참조 파일 |
·문자 코드값 (2바이트) ·색인용어 참조 파일 포인터 (4바이트) |
|
2. 색인 용어별 참조 파일 |
·색인용어 (40바이트) ·색인용어를 갖고 있는 전체 페이지 수 (4바이트) ·전체 문서에서의 색인용어 발생 빈도 (4바이트) ·문헌식별자 참조 파일 포인터 (4바이트) |
|
3. 문헌 식별자 참조 파일 |
·참조 문헌 식별자 (4바이트) ·문서상에서 색인용어가 처음 나오는 위치 (4바이트) ·문서상에서 색인용어 발생 빈도 (4바이트) |
4.4.6 사용자 질의 처리
※ 연산자 처리
까치네는 기본적으로 세가지의 연산을 지원한다.
|
종류 |
연산자 |
예 |
|
논리합 |
& |
까치 & lactt |
|
논리곱 |
"|" 또는 스페이스(공백) |
까치 | lactt , 까치 lactt |
|
NOT |
! |
까치 ! lactt |
4.5 부분 검색 서비스
최근 WWW의 폭발적인 증가로 인하여 검색어를 입력하여도 자신이 원하
는 정보를 찾기란 쉽지 않
다. 너무 많은 URL들이 나오기 때문이다. 그러므로 부분 검색은 반드시 필요하다. 즉 지금의 야
후 형태의 분야별 검색이
나 까치네에서 하고 있는 도메인별 검색처럼 사용자들이 검색 대상을 적절히 조정한다면 더욱 빠
르게 자신이 원하는 정보
를 얻을 수 있을 것이다.
5. 전체영역에서의 적용
도메인별 구분 자를 이용한 로봇은 도메인의 수가 1000개 이하이고, 또 각 도메인의 페이지 수가 3000페이지 이하인 국내라는 비교적 제한된 공간에서 적합한 모델이라고 할 수 있다.
그러나 전체 영역에 해당되는 전 세계의 공간에서 살펴보면 다음과 같은
몇 가지 문제가 발생한
다.
- 도메인의 부피적인 증가
너무 많은 도메인으로 말미암아 많은 수의 going, gone저장 시스템이 필 요하게 되고 Full Text의 결과 저장 시스템도 도메인 수별로 생성된다[6].
또 각 로봇 프로세스가 각 도메인별로 수행되려면 다른 도메인 프로세서
는 많은 시간을 대기해야
한다.
- 도메인별 페이지 수의 차이 심화
전체적 영역에서 살펴보면 너무 많은 페이지를 소유한 도메인들과 단 한두
페이지를 소유한 도메인
이 있다[6]. 이런 상황에서 도메인별로 구분하여 로봇 프로세서를 수행하게 되면 많은 페이지들
을 소유한 도메인에서는
going, gone저장 시스템의 부하가 커지는 등 일반적인 로봇알고리즘을 사용했을 때와 같은 문제
가 발생하게 된다. 또한 적
은양의 페이지를 소유한 도메인을 위해 별도의 저장시스템을 준비해야 한다. 이러한 도메인내 페
이지수의 심한 차이로 인
해 이의 성능향상은 도메인 수와는 상관없게 된다.
6. 결론
웹서버의 부하를 최대한 줄이면서 정확한 정보를 최대한 빠르게 모아오
는 로봇 알고리즘에 대한
본 연구에서, 비교적 제한된 공간을 통해 도메인이라는 특별한 구분방식을 사용하였으며, 이로 인
해 상대편 시스템의 네트
웍과 서버의 부하를 줄이고 전체적인 로봇성능을 향상시켰다. 한정된 영역속에서도 그 영역의
성격이 달라짐에 유동적으
로 대처하는, 그 환경에 맞는 적절한 로봇알고리즘이 개발되어야 할 것이다.
참고문헌
[1] 김성훈,"까치네, 국내 웹사이트 얼마나 되나". <URL:http://www.taegu.ac.kr/ka>
[2] 이강준, "World-Wide Web을 위한 한글 병렬 서치엔진",한 국정보과학회, 23권 1호. 1996.4 p.139-142
[3] 조건준, "웹 서치엔진에 대한 고찰 및 개선방향",한국정보과 학회, 제 23권 1호, 1996.4. p. 557-560
[4] 김병학, "정보 검색을 위한 인텔리젼트 웹 에이전트", WWW-KR 제3회 WorkShop 1996.3 p. 204-214
[5] 양재수, "인터넷서비스와 향후 발전전망". 정보통신학 회지 제 13권2호 1996. p.36-41
[6] Gray, M. "Growth of the World-Wide Web",<URL:http://www.mit.edu:8001/aft/sipb/user/mkgray/ht/web-growth.html>
[7] Koster, M. "Guidelines for Robot Writers".<URL:http://web.nexor.co.uk/mak/doc/robots/guidelines.html>
[8] Koster, M. "A Standard for Robot Exclusion".<URL:http://web.nexor.co.uk/mak/doc/robots/norobots.html>
[9] "HyperText Transfer Protocol".<URL:http://www.w3.org/pub/WWW/Protocols>
[10] Koster, M. "List of Robots", <URL:http://web.nexor.co.uk/mak/doc/robots/active.html>
[11] W. Richard Stevens. "TCP/IP Illustrated". Vol 3. 1996.1. p. 161-205