 정보탐정의 설계 및 구현정보탐정의 설계 및 구현
김형근
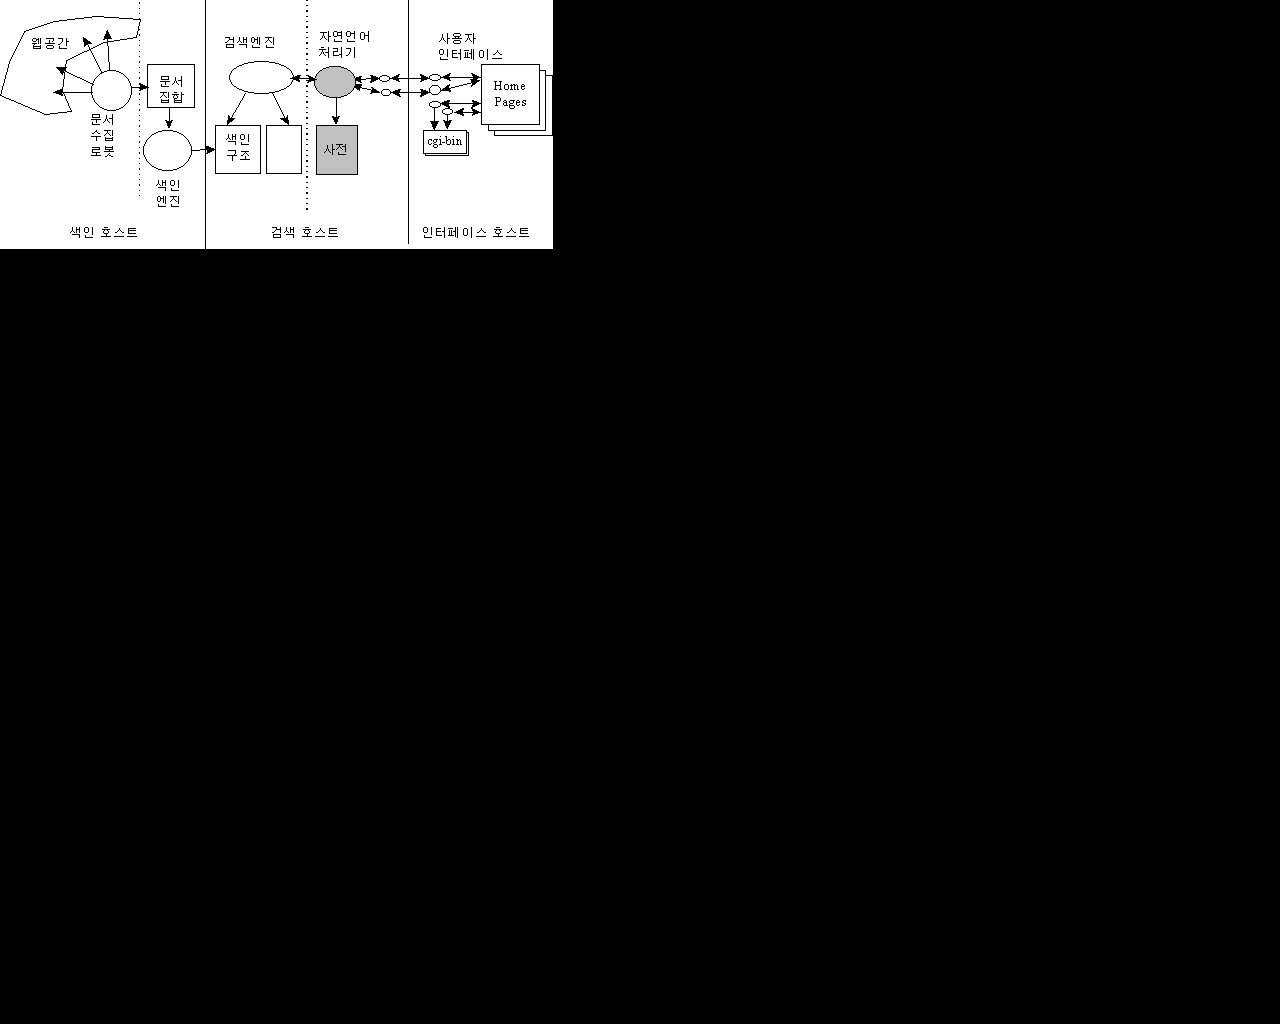
안정적인 서비스가 필수적으로 요구되는 경우 손쉽게 이중화할 수 있는 구조인 것이다.
구체적으로 '정보탐정'에 한정시키서 생각한다면,
시그너처의 폭(혹은 길이)가 고정적인 크기이므로 입력문서의 갯수만 알면 필요한 시그너쳐 색인 파일의 크기는 산술적으로 계산할 수 있다. 시그너쳐 색인을 만드는 것은 다른 요소와는 (거의) 무관하게 문서의 갯수에만 선형적으로 증가하기 때문에, 대량의 문서를 다루는데 적합하다.
또한 시그너쳐를 만드는 과정이 단순한 산술적인 해슁함수를 사용하는 것이므로, 매우 견고한 색인기를 만들 수 있는 장점이 있다.
다음 그림은 시그너쳐를 이용한 색인구조와 새로운 질의어가 들어왔을 때, 그것을 시그너쳐로 변환하여 검색하는 것을 도해한 것이다.
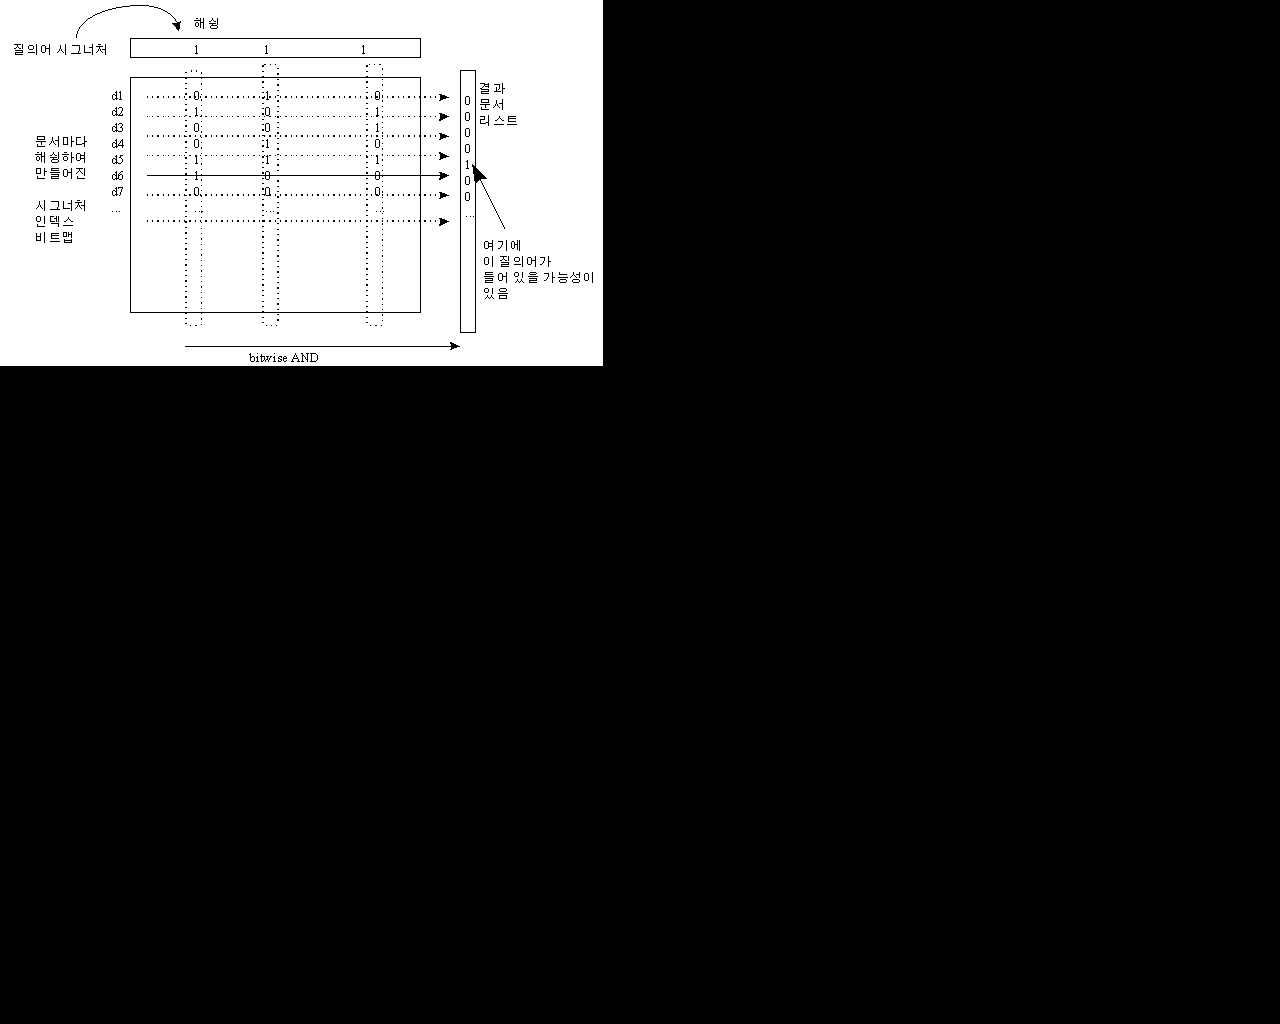
시그너쳐의 문제점은 이렇게 찾아낸 비트행만 가지고 검색이 끝나지 않고, 다시한번 원래의 문서를 뒤져서 실제로 그 단어가 그 문서에 들어있는지를 점검하는 작업이 필요하다는 것이다. (false drop checking) 정보탐정의 경우 상위 수십개에 대해서만 점검하기 때문에 크게 속도가 떨어지지 않도록 유지할 수가 있다.
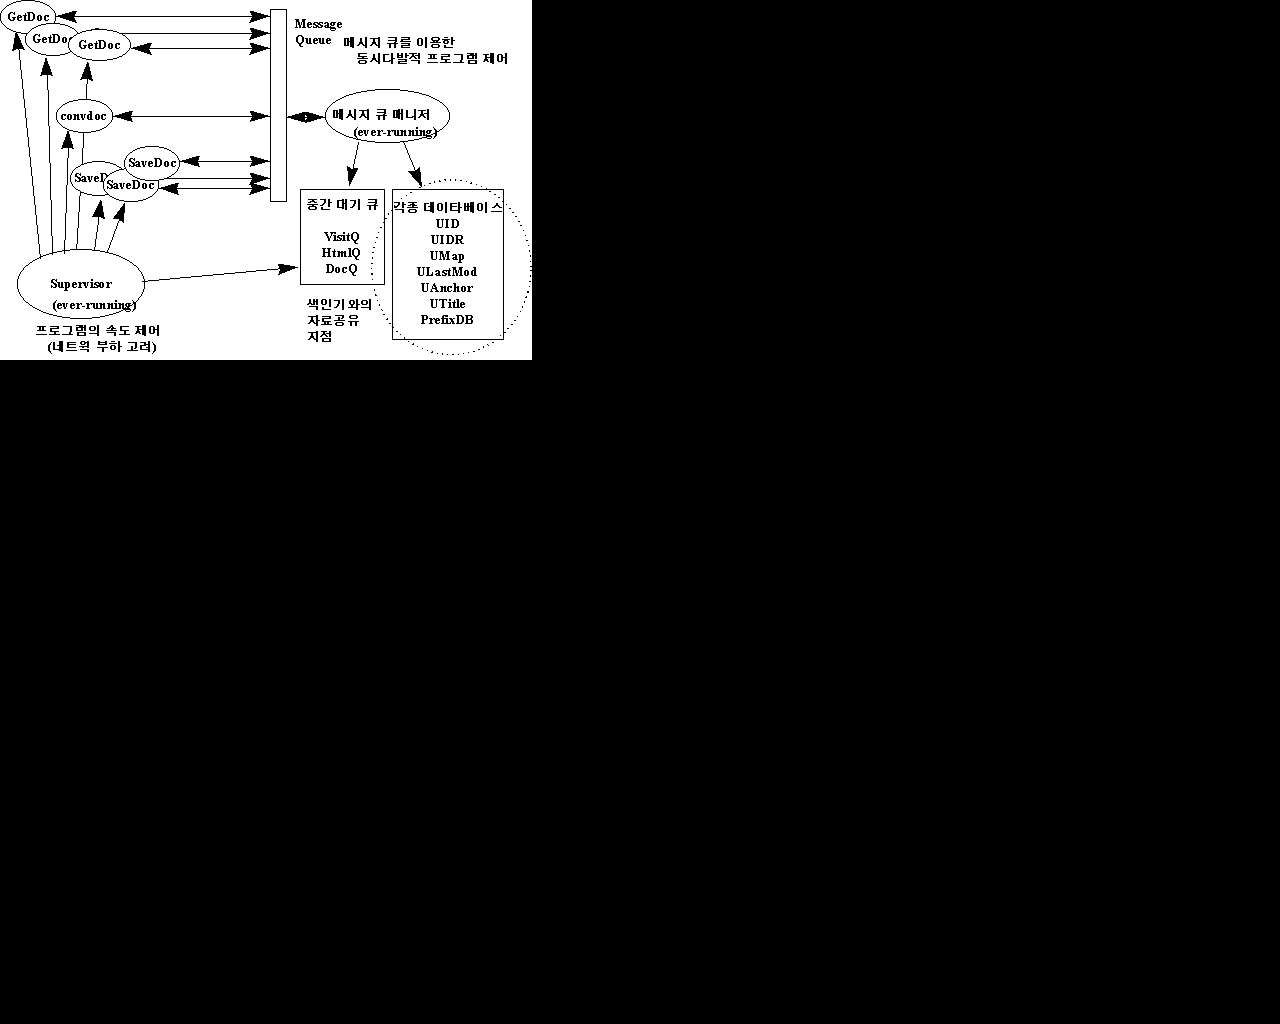
이렇게 여러 프로그램들이 비동기적으로 협동해가면서 만들어내는 자료 구조는 다음과 같다.
이 문서 수집기는 실제로 문서수집을 수행시켜 보면 네트웍 부하 때문에, 하루에 최대 10만개정도의 파일밖에 다운로드하지 못한다. 하지만 기존에 가져온 문서위에 또다시 문서를 수집하라고 시키면, 중복되는 것은 다시 가져오지 않기 때문에 높은 효율을 보장할 수 있다.