 WWW Build, Refine and Management
특히 1993년 NCSA (URL: http://www.ncsa.uiuc.edu) 에서 GUI 기반의 Browser 인 Mosaic 이 Internet 에 출현한 이후로 WWW 의 성장율은 네트웍의 성장율을 능가할 정도였고, Internet 의 사용이 곧 WWW 의 사용이라는 도식이 형성될 정도로 발전하였으며, 앞으로도 고속성장은 지속될 전망이다.
이러한 일련의 성장의 분위기는 '정보의 보고' 라고 일컬어지는 Internet 에서 단순히 자신이 필요한 정보를 찾기만 하는 것이 아니라, 자신이 직접 정보의 제공자 역할을 하고 싶다는 욕구를 창출하게 되었고 이것이 Web 서버수의 폭발적 증가의 주요 요인으로 등장하게 되었다.
이 문서에서는 그러한 욕구를 만족시키기 위해서 초보자들도 쉽게 Web 서버를 설치할 수 있도록 setup 과정을 자세히 설명하고, CGI (Common Gateway Interface) 의 개념과 CGI 프로그래밍을 이해하고 실제로 설치해 봄으로써 CGI 를 사용할 수 있도록 한다. 또한, Web 서버를 구동할 때 생성되는 Log file 들이 어떻게 구성되어 있으며 분석 Tool 을 사용해서 분석하는 방법과 분석한 자료들을 어떻게 이용할 것인지에 대해서 논의해 보기로 한다.
Web 서버의 역할은 Browser 를 통하여 접수된 사용자(End-User) 의 요구(Request)에 답하여(Response) 잘 정리된 (HTML 로 쓰여진) 데이타를 사용자에게 전송하는 것이다.
말하자면, Web 서버는 사용자의 요구에 응하여 HTML 형태로 정리된 데이타를 전송하는
역할을 하는 것이다. 이외에도 Web 서버는 보안(Security) 과 사용기록(Account)를
위한 Log file 을 생성하고 CGI 등을 통해서 여러가지 환경을 제공한다.
무상으로 제공되는 Web 서버도 현재 다양한 제품이 나와 있으므로, 서버를 선택할때는 우선 각 서버의 장/단점을 파악하고, 서버 설치와 유지의 용이성 및 성능의 측면을 고려해야 할 것이다. 성능의 측면에서는 잘 정리된 자료 (URL: http://www.ncsa.uiuc.edu/InformationServers/Performance/V1.4/report.html) 를 구할 수 있다.
고성능이며 서버 Configuration 이 비교적 용이하다고 알려진 NCSA 서버를 고쳐서 만들었다는 A PAtCHe Server (URL: http://www.apache.org) 를 보면 NCSA 서버보다 더 빠르고 효율적이라는 것을 알 수 있다.
우리는 APACHE HTTP Server 를 선택 하였다.
물론, 한국에 있다면 APACHE 서버의 미러링 사이트 (URL: http://cosmos.kaist.ac.kr/packages/www/apache/) 를 이용하는 것이 더 빠를 것이다.
현재의 APACHE 서버의 버전은 1.1.1 이다. 1.0.0 에서의 개선사항중 주요한 몇가지는 다음과 같고, 더 자세한 내용은 New Features (URL: http://cosmos.kaist.ac.kr/packages/www/apache/docs/1.1/)를 참고하면 된다.
% gzip -cd apache_1.1.1-sparc-sun.sunos4.1.4.tar.gz | tar xvf -apache_1.1.1 이란 디렉토리가 생기게 되고, 그 밑에 모든 자료들과 프로그램들이 위치하게 된다. 기존에 설치된 서버의 Configuration file 을 그대로 이용하기 위해서는 apache_1.1.1 디렉토리를 httpd 로 이름을 바꾸어주던가 Symbolic link 를 시켜줘야 한다. 다음은 SunOS 4.1.4 시스템의 httpd 디렉토리 구조를 보여준다.
total 21
drwxr-xr-x  9 loveiris staff         512 Oct 15 11:27 ./
drwxr-xr-x  4 loveiris staff         512 Oct 14 22:50 ../
-rw-r--r--  1 loveiris staff        3738 Mar 13  1996 CHANGES
-rw-r--r--  1 loveiris staff        2604 Feb 22  1996 LICENSE
-rw-r--r--  1 loveiris staff        3059 Jul  3 15:24 README
drwxr-xr-x  2 loveiris staff         512 Jul  9 04:04 cgi-bin/
drwxr-xr-x  2 loveiris staff         512 Oct 15 11:12 conf/
drwxr-xr-x  2 loveiris staff         512 Jul  9 04:04 htdocs/
drwxr-xr-x  2 loveiris staff        2048 Jul  9 04:04 icons/
drwxr-xr-x  2 loveiris staff         512 Jul  9 04:04 logs/
drwxr-xr-x  2 loveiris staff        2048 Oct  5 10:18 src/
drwxr-xr-x  2 loveiris staff         512 Oct  5 10:19 support/
# This should be changed to whatever you set DocumentRoot to.
<Directory /usr/local/etc/httpd/htdocs>

# This may also be "None", "All", or any combination of "Indexes",
# "Includes", "FollowSymLinks", "ExecCGI", or "MultiViews".

# Note that "MultiViews" must be named *explicitly* --- "Options All"
# doesn't give it to you (or at least, not yet).

Options Indexes FollowSymLinks
DocumentRoot 는 사용자가 Web 서버에 접속했을때 가장 먼저 보여주는 HTML 문서가 위치할 곳을 지정해 주는 곳이며, Web 서버에서 제공하는 각종 문서들이 저장되고 관리되는 일종의 홈 디렉토리이다. 이것을 사용할때 'Option' 을 지정해 줄 수 있는데, 이는 디렉토리 화일들에 대한 서버의 활용 방법을 지정해 주는 역할을 한다. 여러가지 Option 이 있을 수 있는데 몇가지만 살펴보도록 한다.
# This controls which options the .htaccess files in directories can
# override. Can also be "All", or any combination of "Options", "FileInfo",
# "AuthConfig", and "Limit"

AllowOverride None
AllowOverride 라는 것은 어떤 디렉토리나 화일에 대한 접속을 특정 집단이나 사용자들 에게만 허용할 목적으로 그 디렉토리에 .htaccess 를 설치하였을때 그 디렉토리의 내용을 보여줄 것인지 아닌지를 결정하게 한다.
# Controls who can get stuff from this server.

order allow,deny
allow from all

</Directory>
order 라는 것은 서버가 접근 제어를 수행할때 실행되는 순서를 나타낸다. 위의 경우는 allow 기능을 수행한 후에 deny 기능을 수행하는 것을 나타낸다. 'deny, allow' , 'allow, deny', 'mutual-failure' 의 3가지 중에서 하나를 선택해야 한다. 마지막의 mutual-failure의 경우에는 접근을 허용하거나 거부할 호스트 주소를 allow 와 deny 에 반드시 나타내야 한다. 이 경우 allow 에 나타나는 주소는 어떤 것이든지 접근이 허용되고, deny 에 나타나는 것은 어떤 것이든지 거부되며, 어느 쪽에든 명시되지 않은 것들은 접근 거부된다.
deny from 은 열거된 주소들에 대해서는 접근을 거부하겠다는 것을 나타내며, 주소를 나타낼때는 도메인이름, 호스트이름, 호스트 IP, IP 앞부분 3 바이트를 쓸 수 있고, 모든 호스트에 대해 일차적인 접근 거부를 나타낼때는 all 이 쓰인다.
allow from 은 나열되어 있는 주소들에 대해 접근을 허용하겠다는 것을 나타내며 주소를 나타내는 방법은 위와 동일하다.
# /usr/local/etc/httpd/cgi-bin should be changed to whatever your ScriptAliased
# CGI directory exists, if you have that configured.

<Directory /usr/local/etc/httpd/cgi-bin>
AllowOverride None
Options None
</Directory>
이 부분은 WWW 서버가 사용할 CGI 들이 들어있는 디렉토리를 지정하는 것이고 Option, AllowOverride 는 위의 것과 같은 역할을 하게 된다.
# Allow server status reports, with the URL of http://servername/status
# Change the ".nowhere.com" to match your domain to enable.

#<Location /status>
#SetHandler server-status

#order deny,allow
#deny from all
#allow from .nowhere.com
#</Location>
APACHE httpd 1.1.1 에서 추가된 부분으로, 이 부분을 설정해 두면 특정 호스트 혹은 도메인에서 접속하는 Client 들에 대한 정보를 얻을 수 있게 된다. Server Statistics 를 보는 방법은 아래와 같다.
http://your.server.name/status/
# ServerType is either inetd, or standalone.

ServerType standalone

# If you are running from inetd, go to "ServerAdmin".
inetd 방식이라는 것은 inetd 라는 process 가 있다가 사용자의 요구가 들어올때마다 새로운 httpd process 를 생성시켜서 사용자의 요구를 처리하도록 하는 방식이고, standalone 방식이라는 것은 Server pool 방식과 같은 것으로서 서버 process 를 미리 만들어 놓고 사용자의 요구가 들어오는대로 대기하고 있는 서버 process 에게 일을 할당하는 방식이다. 이 방법은 사용자의 요구가 있을때마다 새로운 process 를 생성(fork) 하는 inetd 방식보다 서버를 새로 생성하는 시간을 줄임으로서 보다 빠른 반응속도를 얻을 수 있다는 장점이 있다. Unix 에서 fork 는 시간이 많이 걸리는 작업중 하나로 Server pool 방식은 사용자의 수가 많아질수록 상당한 성능의 향상을 가져오게
되며, 실제의 실험결과 (URL: http://www.ncsa.uiuc.edu/InformationServers/Performance/V1.4/report.html) 도 이 사실을 입증해 준다.
# Port: The port the standalone listens to. For ports < 1023, you will
# need httpd to be run as root initially.

Port 80
0 에서 1023 까지의 port 는 시스템에 미리 예약이 되어 있으며 주요 서비스에 대해서는 고유 port 번호가 할당되어 있다. httpd 을 위한 port 번호는 80 번이고 이것을 Default 로 사용한다. 1024 번보다 큰 port 번호의 사용은 일반 사용자도 가능하도록 되어 있으며 접속할때는 아래의 예와 같이 URL 에 port 번호까지 명시를 해주어야 한다.
http://ktmp.kaist.ac.kr:8080/
# HostnameLookups: Log the names of clients or just their IP numbers
#   e.g.   www.apache.org (on) or 204.62.129.132 (off)
HostnameLookups on
Log file 에 기록되는 Client 들이 어디에서 접속하였는지에 대한 정보를 IP address 로 남길것인지 혹은 호스트 이름으로 남길것인지를 결정하는 부분이다.
# If you wish httpd to run as a different user or group, you must run
# httpd as root initially and it will switch.

# User/Group: The name (or #number) of the user/group to run httpd as.
#  On SCO (ODT 3) use User nouser and Group nogroup
User nobody
Group #-1
standalone 방식으로 서버를 구동시켰을때 사용되는 것으로 httpd 서버가 사용자들의 요구에 대해서 생성시키는 Child process 에 대한 UID, GID 를 지정해 주는 부분이다. root 와 같이 시스템을 관리하는 사람의 UID 나 GID 를 사용하는 경우는 httpd process 가 root 의 권한을 가지게 되므로 잘못하면 시스템이 크래킹을 당할수도 있게 된다. 그러므로 대개 nobody 그룹및 nobody 사용자에 대해 정의를 하게 된다. OS 의 종류에 따라서 설정하는 방식이 다르므로 주의해야 한다.
# ServerAdmin: Your address, where problems with the server should be
# e-mailed.

ServerAdmin you@your.address

# ServerRoot: The directory the server's config, error, and log files
# are kept in

ServerRoot /usr/local/etc/httpd
서버 관리자의 E-mail address 를 적어주는 곳이고, ServerRoot 라는 것은 httpd 서버 프로그램이 설치된 디렉토리를 적어주면 된다.
# BindAddress: You can support virtual hosts with this option. This option
# is used to tell the server which IP address to listen to. It can either
# contain "*", an IP address, or a fully qualified Internet domain name.
# See also the VirtualHost directive.

#BindAddress *
BindAddress 뒤에 나열된 호스트 주소에서의 접속만을 허용한다. 접근 통제를 목적으로 이용될 수 있으며 뒤에서 설명될 Virtual host 와는 함게 쓰일 수 없다.
# ErrorLog: The location of the error log file. If this does not start
# with /, ServerRoot is prepended to it.


ErrorLog logs/error_log

# TransferLog: The location of the transfer log file. If this does not
# start with /, ServerRoot is prepended to it.

TransferLog logs/access_log

# PidFile: The file the server should log its pid to
PidFile logs/httpd.pid

# ScoreBoardFile: File used to store internal server process information
ScoreBoardFile logs/apache_status
Log file 의 이름과 위치를 지정해주는 부분이다. 자세한 것은 Log analyzer 부분에서 다루도록 한다.
# ServerName allows you to set a host name which is sent back to clients for
# your server if it's different than the one the program would get (i.e. use
# "www" instead of the host's real name).
#
# Note: You cannot just invent host names and hope they work. The name you
# define here must be a valid DNS name for your host. If you don't understand
# this, ask your network administrator.

#ServerName new.host.name
Web 서버의 이름을 정하는 부분으로 보통 호스트의 이름을 써주지만, 꼭 호스트 이름과 같을 필요는 없다. 예를 들어, www.your.domain.name 이라고 하면 그 도메인의 대표 Web 서버가 되는 것이 보통이다.
# KeepAlive: The number of Keep-Alive persistent requests to accept
# per connection. Set to 0 to deactivate Keep-Alive support

KeepAlive 5

# KeepAliveTimeout: Number of seconds to wait for the next request

KeepAliveTimeout 15
원하는 자료를 찾기 위해서 특정 서버에 접속을 했다고 했을때, 보통의 경우 단 한가지의 자료만을 얻기 위해서 접속한 경우는 드물 것이다. 대부분 여러개의 문서들을 뒤적이면서 찾아야 할 경우가 많다. 그런데, 실제로 어떤 Browser 가 서버에서 데이타를 가지고 올때는 각각의 화일마다 다른 TCP connection 을 이루어서 문서를 가져오게 된다. 즉, 우리가 10 개의 화일이 필요해서 받아올때는 10개의 서로 다른 TCP connection 이 생기게 되는 것이다. 속도가 빠른 경우라면 별 문제가 없겠지만 만약 속도가 너무나 느린 경우라면 사용자의 관점에서는 짜증나는 일이 될 것이다.
이를 해결하기 위해서 APACHE 서버에서는 어떤 서버에 접속을 한 경우, 일정 시간동안은 사용자의 요구가 없더라도 연결을 지속시킨다. 그러다가, 어떤 일정 시간동안 사용자의 요구가 없으면 비로소 연결을 종료시킨다. 이 방법은 어떤 서버에 빈번하게 접속하는 경우에 속도의 향상을 가져올 수 있다.
하지만 이를 시스템의 관점에서 보면 어떻게 될까? 서버의 관점에서 사용자의 요구도 없는데 계속해서 Connection 을 맺고 있는다는 것은 큰 부하로 작용하게 된다. 즉, 이를 방지하기 위해서 KeepAliveTimeout 을 설정하게 된다. 위의 예에서 15 라는 것은 15 초를 의미한다. 즉, 15초동안 사용자의 요구가 없었다면 Connection 을 종료시키겠다는 것을 나타낸다.
# Server-pool size regulation.  Rather than making you guess how many
# server processes you need, Apache dynamically adapts to the load it
# sees --- that is, it tries to maintain enough server processes to
# handle the current load, plus a few spare servers to handle transient
# load spikes (e.g., multiple simultaneous requests from a single
# Netscape browser).

# It does this by periodically checking how many servers are waiting
# for a request.  If there are fewer than MinSpareServers, it creates
# a new spare.  If there are more than MaxSpareServers, some of the
# spares die off.  These values are probably OK for most sites ---

MinSpareServers 5
MaxSpareServers 10

# Number of servers to start --- should be a reasonable ballpark figure.

StartServers 5

# Limit on total number of servers running, i.e., limit on the number
# of clients who can simultaneously connect --- if this limit is ever
# reached, clients will be LOCKED OUT, so it should NOT BE SET TOO LOW.
# It is intended mainly as a brake to keep a runaway server from taking
# Unix with it as it spirals down...

MaxClients 150

# MaxRequestsPerChild: the number of requests each child process is
#  allowed to process before the child dies.
#  The child will exit so as to avoid problems after prolonged use when
#  Apache (and maybe the libraries it uses) leak.  On most systems, this
#  isn't really needed, but a few (such as Solaris) do have notable leaks
#  in the libraries.

MaxRequestsPerChild 30
앞서 언급한 Server pool 방식을 이용할때 이용되는 부분으로서 StartServers 는 최초에 몇 개의 httpd process 를 생성시켜 놓을 것인가 지정하는 것이고, Min/Max Spare Servers 라는 것은 일정 시간마다 현재 대기하고 있는 서버의 갯수를 확인하여 최소 서버의 수보다 적을때는 process 를 더 생성시키고 남을 경우는 process 를 없애는 역할을 해서 항상 일정 숫자의 서버가 대기하고 있도록 해주는 역할을 하며, MaxClients 는 서비스를 제공하는 동안 최대 몇 개의 process 를 생성 가능하게 할 것인가 지정하는 것이다.
최대 갯수 제한의 목적은 httpd process 에 의해 시스템이 지나친 부하를 받지 않게 하는데 있고, 이를 초과하는 사용자 요구가 동시에 들어오는 경우는 서비스를 거부하게 된다.
# Listen: Allows you to bind Apache to specific IP addresses and/or
# ports, in addition to the default. See also the VirtualHost command

#Listen 3000
#Listen 12.34.56.78:80
지정된 호스트의 port 에서 Socket connection 을 열어두고 대기하겠다는 것을 나타낸다.
# VirtualHost: Allows the daemon to respond to requests for more than one
# server address, if your server machine is configured to accept IP packets
# for multiple addresses. This can be accomplished with the ifconfig
# alias flag, or through kernel patches like VIF.

# Any httpd.conf or srm.conf directive may go into a VirtualHost command.
# See alto the BindAddress entry.

#<VirtualHost host.foo.com>
#ServerAdmin webmaster@host.foo.com
#DocumentRoot /www/docs/host.foo.com
#ServerName host.foo.com
#ErrorLog logs/host.foo.com-error_log
#TransferLog logs/host.foo.com-access_log
#</VirtualHost>
Virtual Host 란 하나의 서버에 몇 개의 IP 주소를 할당하여, 어느 IP 주소로 들어온 서비스 요구인지 알아내어 해당하는 별도의 서버 홈페이지로 연결해주는 것을 말한다. 이것을 이용하여 한 대의 호스트에서 서로 다른 IP 주소를 가지는 여러 곳의 서버 홈페이지를 구성할 수가 있다.
호스트 내 사용자와 외부에서 접속하는 사용자에 대해 다른 서비스를 제공해주자 할 때 위와 같은 방식으로 서비스 할 수 있다. 물론, 이런 기능을 이용하기 위해서는 하나의 호스트에 여러 개의 IP 주소를 할당할 수 있는 시스템이라야한다.
# DocumentRoot: The directory out of which you will serve your
# documents. By default, all requests are taken from this directory, but
# symbolic links and aliases may be used to point to other locations.

DocumentRoot /usr/local/etc/httpd/htdocs
앞에서 언급된 access.conf 화일의 DocumentRoot 와 같은 기능을 한다.
# UserDir: The name of the directory which is appended onto a user's home
# directory if a ~user request is recieved.

UserDir public_html
각 사용자들의 개인 Home page 디렉토리를 지정한다. 이때의 디렉토리명은 /etc/passwd 화일에 나타난 사용자의 Home 디렉토리에서 상대적으로 지정된다. 만약 개인 사용자가 자신의 Home page 를 구축하려 한다면 자신의 Home 디렉토리 밑에 public_html 이란 디렉토리를 만들고 그것을 Home 디렉토리로 하여 HTML 문서들을 작성하면 된다.
# DirectoryIndex: Name of the file or files to use as a pre-written HTML
# directory index.  Separate multiple entries with spaces.

DirectoryIndex index.html
특정 화일을 지정하지 않고 디렉토리이름으로만 URL 을 지정하였을때 그 디렉토리에서 Default 로 찾게되는 화일의 이름을 나타낸다. 여러개를 지정할 수 있다.
# FancyIndexing is whether you want fancy directory indexing or standard
FancyIndexing on
디렉토리나 화일의 목록을 보여줄때, 화일의 크기나 종류 또는 확장자에 따라서 지정된 Icon 으로 보여줄 것인지를 지정해 주는 부분이다.
# AddIcon tells the server which icon to show for different files or filename
# extensions

AddIconByEncoding (CMP,/icons/compressed.gif) x-compress x-gzip

AddIconByType (TXT,/icons/text.gif) text/*
AddIconByType (IMG,/icons/image2.gif) image/*
AddIconByType (SND,/icons/sound2.gif) audio/*
AddIconByType (VID,/icons/movie.gif) video/*
...
디렉토리 index 의 주어진 화일 형태에 대해서 출력할 Icon 을 미리 지정해 주는 부분이다. 사용자의 편의에 따라서 덧붙일 수 있다.
# DefaultIcon is which icon to show for files which do not have an icon
# explicitly set.

DefaultIcon /icons/unknown.gif
위에서 지정한 Icon 정보가 없는 화일을 보여줄때 Default 로 보여지는 Icon 을 나타낸다.
# AddDescription allows you to place a short description after a file in
# server-generated indexes.
# Format: AddDescription "description" filename
FancyIndexing 에서 사용되는 화일에 대한 간단한 설명을 지정해주는 부분이다. 'filename' 부분에는 확장자나 화일이름 혹은 Wildcard 표현방법이 들어갈 수 있다.
# ReadmeName is the name of the README file the server will look for by
# default. Format: ReadmeName name
#
# The server will first look for name.html, include it if found, and it will
# then look for name and include it as plaintext if found.
#
# HeaderName is the name of a file which should be prepended to
# directory indexes.

ReadmeName README
디렉토리 목록을 출력할때, 디렉토리 index 뒷부분에 같이 출력해줄 화일명을 지정해 주는 부분이다. WWW 를 이용하여 Ftp service 를 겸하고자 하는 경우 유용하게 사용되는 부분이다.
HeaderName HEADER위의 것과는 달리 앞부분에 덧붙일 디렉토리의 Custom header 화일을 지정하는 부분이다.
# IndexIgnore is a set of filenames which directory indexing should ignore
# Format: IndexIgnore name1 name2...

IndexIgnore */.??* *~ *# */HEADER* */README* */RCS
디렉토리 index 를 출력할때 무시할 화일명을 지정한다.
# AccessFileName: The name of the file to look for in each directory
# for access control information.

AccessFileName .htaccess
Client 로 문서가 전달될때 서버는 각 디렉토리마다 AccessFileName 에서 지정한 이름을 가진 화일이 있는지를 찾아본 후에 접근 제어를 할 것인지 아닌지를 결정하게 된다.
# DefaultType is the default MIME type for documents which the server
# cannot find the type of from filename extensions.

DefaultType text/plain
어떤 화일의 형태가 서버가 가지고 있는 MIME.type 과 일치하지 않을때, 그 화일을 어떤 형태로 보여줄 것인지를 결정하는 변수이다.
# AddEncoding allows you to have certain browsers (Mosaic/X 2.1+) uncompress
# information on the fly. Note: Not all browsers support this.

AddEncoding x-compress Z
AddEncoding x-gzip gz
화일의 확장자에 따라 지정된 화일형태로 인식을 하도록 정의해 주는 부분이다.
# Redirect allows you to tell clients about documents which used to exist in
# your server's namespace, but do not anymore. This allows you to tell the
# clients where to look for the relocated document.
# Format: Redirect fakename url
특정한 이름으로 들어오는 서비스 요청을 직접 처리하지 않고 다른 서버에게 넘겨주고자 할때 사용된다. 여러 곳에 분산되어 있는 서버의 데이타를 하나의 URL 에서 처리를 해줄 수 있다는 장점이 있다.
# Aliases: Add here as many aliases as you need (with no limit). The format is
# Alias fakename realname

#Alias /icons/ /usr/local/etc/httpd/icons/
서버 관리자가 어떤 사정에 의해서 현재까지 사용하던 디렉토리의 경로를 바꾼다던가 혹은 디렉토리의 이름을 바꾸었을때 기존의 사용자들이 아무런 불편없이 계속해서 사용할 수 있도록 조처를 취해줄때나 혹은 복잡한 디렉토리구조를 가지고 있는 경우 복잡함을 줄이기위해 사용할 수 있는 방법이며, 지정할 수 있는 Alias 의 수는 제한이 없다.
# ScriptAlias: This controls which directories contain server scripts.
# Format: ScriptAlias fakename realname

#ScriptAlias /cgi-bin/ /usr/local/etc/httpd/cgi-bin/
Web 서버에서 사용하는 CGI script 를 저장하고 있는 디렉토리를 지정한다. 이 디렉토리 내에 있는 화일은 읽혀지는것이 아니라 실행되게 된다.
# AddHandler allows you to map certain file extensions to "handlers",
# actions unrelated to filetype. These can be either built into the server
# or added with the Action command (see below)
# Format: AddHandler action-name ext1

# To use CGI scripts:
#AddHandler cgi-script .cgi

# To use server-parsed HTML files
#AddType text/html .shtml
#AddHandler server-parsed .shtml

# Uncomment the following line to enable Apache's send-asis HTTP file
# feature
#AddHandler send-as-is asis

# If you wish to use server-parsed imagemap files, use
#AddHandler imap-file map

# To enable type maps, you might want to use
#AddHandler type-map var
화일의 특정한 확장자를 지정해서 그 확장자를 가진 화일은 어떤 프로그램으로 인식 하라는 것을 지정해 주는 부분이다. 윗 부분을 설정해 주면, 서버는 .cgi 라는 확장자를 가지는 화일은 CGI-script 로 인식을 하게 되고, .shtml 라는 확장자를 가진 화일은 Server-parsed HTML 로 인식하게 된다.
# Action lets you define media types that will execute a script whenever
# a matching file is called. This eliminates the need for repeated URL
# pathnames for oft-used CGI file processors.
# Format: Action media/type /cgi-script/location
# Format: Action handler-name /cgi-script/location

# For example to add a footer (footer.html in your document root) to
# files with extension .foot (e.g. foo.html.foot), you could use:
#AddHandler foot-action foot
#Action foot-action /cgi-bin/footer

# Or to do this for all HTML files, for example, use:
#Action text/html /cgi-bin/footer
정의된 Media type 이 나오게 되면 특정 CGI script 를 실행해주는 역할을 한다.
# MetaDir: specifies the name of the directory in which Apache can find
# meta information files. These files contain additional HTTP headers
# to include when sending the document

#MetaDir .web

# MetaSuffix: specifies the file name suffix for the file containing the
# meta information.

#MetaSuffix .meta
HTTP header 부분에 들어가는 meta 정보들을 포함하는 디렉토리와 그 화일의 확장자를 지정해주는 부분이다.
# Customizable error response (Apache style)
#  these come in three flavors
#
#    1) plain text
#ErrorDocument 500 "The server made a boo boo.
#  n.b.  the (") marks it as text, it does not get output
#
#    2) local redirects
#ErrorDocument 404 /missing.html
#  to redirect to local url /missing.html
#ErrorDocument 404 /cgi-bin/missing_handler.pl
#  n.b. can redirect to a script or a document using server-side-includes.
#
#    3) external redirects
#ErrorDocument 402 http://other.server.com/subscription_info.html
어떤 page 에 접속을 했을때 그 page 가 없어지거나 혹은 다른 곳으로 옮겨졌거나
했을때 발생하는 Error 의 처리를 어떻게 할 것인지를 지정해 주는 부분이다.
기본적으로 제공되는 Error message 만 출력해 줄수도 있고 관리자가 만든 Error
message 를 출력해 줄수도 있으며 옮겨진 page 를 알려주는 Message 를 넣어줄 수도
있다.
standalone 으로 실행하는 경우는 다음과 같다.
% httpd -r conf_file_path이때 80 번 port 를 사용한다면 root 의 권한으로 실행을 시켜줘야 한다. 그리고, 호스트가 Rebooting 될때마다 자동적으로 실행이 되기를 원한다면, SunOS 4.x 를 사용하는 시스템의 경우는 /etc/rc.local 의 한줄을 추가해야 하며, Solaris 2.x 를 사용하는 시스템 이라면 /etc/rc3.d 디렉토리에 S90locald 라는 이름으로 화일을 만들어서 위의 명령어를 넣어주면 된다.
inetd 로 실행하는 경우에는 /etc/services 라는 화일에 httpd 80/tcp 라는 줄을 추가하고 /etc/inetd.conf 화일에 다음을 첨가하도록 한다.
http stream tcp nowait nobody httpd_path httpd_command만약 NIS 를 실행중이라면, NIS source 화일을 고쳐야하고 다 고친후에 ypmake 를 통해서 해당 호스트에 전달되어야 제대로 작동하게 된다. 그리고나서 inetd 에게 kill -1 로 Hangup Signal 을 주면, 그때부터 HTTP
연결요구가 올때마다 httpd 가 자동적으로 생성되게 된다.
% ps -awux | grep httpdConfiguration file 을 변경한 경우 변경된 내용이 실제로 적용이 되려면 Hangup Signal 을 준다. 그렇게 하면 httpd 를 중단시키지 않고 Configuration file 을 다시 읽도록 할 수 있다.
inetd 로 실행된 경우는 HTTP 연결요구가 올때마다 process 가 생기는 것이므로 /etc/inetd.conf 의 http 부분을 삭제하지 않는 이상 실행을 중지시킬 수 있는 방법은 없다.
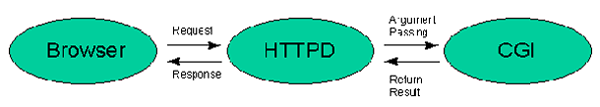
서버측에서만 설치를 하면 여러가지 Client 에 대해서 서버 관리자가 각각 해 주어야 할 일이 줄어들게 된다.
그렇다면 단점에는 어떤 것들이 있는지 알아보도록 하겠다.
CGI 는 서버와는 완전히 독립적인 하나의 process 를 생성하는 것을 말한다. 이것은 서버의 종류에 관계없고 서버 소프트웨어와 호환성이 좋으며, 아주 다양한 분야의 Public Domain Program 이 개발되어 있기 때문에 구현하기가 쉽고 그만큼 널리 사용되고 있다. 이러한 사실들이 CGI 를 Information Server 와 호환되는 외부 Application 의 표준으로 만든 것이다.
이런 강력한(!) 장점을 가지고 있는 반면 각각이 독립적인 process 이기 때문에 Resource 의 낭비가 심하다는 단점을 가진다. 서버가 각각의 Client 의 요구에 새로운 CGI 프로그램을 실행시켜야 한다는 것이다. 이 경우 사용자의 요구가 적을때에는 문제가 되지 않지만, CGI 프로그램이 빈번히 접속된다면 각 요구에 새로운 process 를 생성(fork)하는 것이 서버의 수행능력에 심각한 영향을 미칠것이다.
API 는 서버의 API 를 이용해서 기능을 확장하는 것을 의미한다. Web 서버를 그대로 확장한 결과이기 때문에 속도가 빠르고 효율적이지만 어느 특정 서버의 API 를 이용할 경우엔 다른 서버에서는 사용할 수 없다는 큰 단점이 있다.
Netscape Server API (NSAPI) 는 고성능과 뛰어난 기능 - CGI 프로그램을 작성할때 Shared Library 형태로 만들게 되고, 실행할때에는 Web 서버가 Shared Library 의 함수를 호출하기 때문에 새로운 process 가 생기지 않게 된다- 을 제공하는 CGI 같은 애플리케이션을 만들기 위한 수단으로 제공된다. 예를 들어, NSAPI 는 사용자 접근제어, 에러처리, DB 연결 -CGI 로 구현한다면 서버에 부담을 많이 줄 작업들- 과 같은 일을 처리하기 위해서 사용자 Function 을 작성하는데 사용될 수 있다. 이렇게 NSAPI 가 개발자에게 보다 향상된 기능의 Web 애플리케이션을 만들수 있도록 해주는 반면에 인터페이스에 사용되는 프로그램은 또다른 서버를 지원하기 어렵기 때문에, Netscape Server 에만 연결되어야 한다는 단점이 있다.
이 기능은 서비스를 요구하는 사용자에게 서버 사용자로서 프로그램 실행을 가능하게 하는 역할을 하고 있으므로 시스템 보안상의 문제를 일으킬수도 있다. 그럼에도 불구하고 SSI 는 CGI 를 사용하지 않고서도 제한된 범위의 동적인 HTML 화일을 쉽게 만들 수 있다는 점과 서버측에서 parsing 을 하므로 CGI 의 경우보다 시스템에 부담을 적게 준다는 점이 장점이다.
우선, 기존의 다른 프로그램과 기본적으로 다른 점은 다음과 같다.
1. GET
사용자의 Form 이나 URL 에서 데이타가 오는 방법으로, Form 의 경우 아래와 같은
형태로 보내지게 된다.
그러니까 CGI 프로그래머는 getenv("QUERY_STRING")을 한다음, &, = 를 보고 변수의 이름과 변수안에 들어있는 값을 구분하면 된다.
하지만, 환경변수의 설정시 글자수는 256 자로 제한되므로 BBS 등에서 글을 포스팅 하는 경우는 GET 의 방법을 쓸 수 없다.
2. POST
서버는 CGI 프로그램에 이것을 전달할때 stdin 을 이용한다. 서버는 stdin 에 var1=value1&var2=value2 라고 쓰고, 실제로 CGI 프로그래머는 이것을 해석하는 Routine 을 짜서 &,= 에 따라서 변수 이름과 값을 분리해 낸다. 이 경우 데이타가 서버로 보내어질때 EOF 가 표시되지 않으므로 프로그래머는 CONTENT_LENGTH 라는 환경변수를 받아서 얼마만큼의 데이타가 전송되는지 알아두어야 한다.
이렇게 하면 이제 보통의 C 프로그래밍에서 하던 argc, argv 를 받을 수 있으므로, 그 다음 프로그램은 다른 일반 프로그램과 똑같이 구성하면 된다.
그렇다면 출력하는 부분은 어떻게 될까. CGI 프로그램은 결과를 stdout 에 바로 print 하고 서버는 여기에 출력된 결과를 읽어서 Web Browser 에 보낸다. 일반적으로 결과를 HTML 로 보내므로, 모든 output 을 할때 맨 처음에
CGI 는 실행화일을 만들수 있는 것이면 어느 프로그래밍 언어로 작성해도 무관하다. 하지만, C 로 작성된 것은 Interpret 되는 것이 아니라 Compile 된것이므로 Source code 의 보안문제에 신경을 덜 써도 되고 Perl 같은 Interpreter Script 보다 훨씬 실행속도가 빨라지는 장점을 가지게 된다.
아래의 것은 Client 가 사용하는 Browser 의 종류를 출력해주는 C 프로그램이다. 이 CGI 가 실행될때는 HTTP_USER_AGENT 라는 환경변수를 읽어와서 HTML 형식으로 출력해 준다. 또한 이것은 SSI 를 이용해서 <!--#echo var="HTTP_USER_AGENT"--> 라고 실행해도 된다. 그 예가 이 문서의 맨 끝에 나와있다.
GET 의 방법을 이용해서 서버로 데이타를 보내는 경우는 어떻게 될까? 이름과 신분을 입력받아서 그 자료를 서버로 보내려고 하는 경우 다음 그림과 같이 입력을 받는다고 하자.
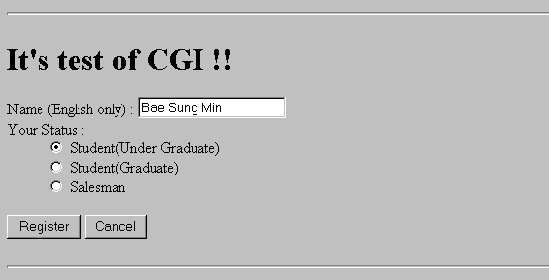
이러한 실행결과를 얻기위해서 작성해야 하는 HTML 문서는 아래와 같다. 윗 형태처럼 사용자의 입력을 받는 것을 FORM 이라 하는데 이외에도 많은 명령어가 있다. FORM 을 만들기 위한 자세한 설명은 생략하도록 한다. 자세한 것은 http://www.ncsa.uiuc.edu/SDG/Software/Masaic/Docs/fill-out-forms/overview.html 를 참조하도록 한다.
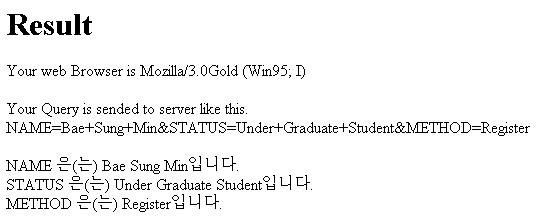
변수와 그 변수가 가지고 있는 값을 분리해주는 프로그램은 GET 의 경우와 POST 의 경우가 다르며, NCSA 에서 여러가지 언어로 작성된 프로그램 (URL: http://hoohoo.ncsa.uiuc.edu/cgi/forms.html) 을 공개해 놓았으므로 이를 이용하면 간단하게 결과를 얻을 수 있을 것이다.
또한 CGI 프로그래밍을 더 쉽게 해주기 위해서 여러가지 Library 가 제공되고 있으며 필자가 자주 이용하는 C Library 는 http://www.boutell.com/cgic 이다. 자세한 내용은 위의 URL 을 참조하기 바란다.
지각있는 WWW 관리자라면 그가 제공한 정보들이 얼마만큼 이용되고 있고, 그들의 정보를 필요로하는 사람들은 어떤 사람들이며, 어떤 형태의 자료가 가장 많이 이용되고 있느냐 하는 여러가지 사실에 대해서 궁금해 할 것이고, 그에 대한 결과를 더 나은 정보의 제공과 환경의 제공이라는 것에 이용함으로써 더 향상된 서비스를 하게 될 것이다.
그렇다면 이런 궁금한 사실들을 알아볼 수 있으려면 어떻게 해야할 것인가?
서버를 구동시키면 자동적으로 생성되는 Log file 들이 있다. 이것들은 그대로 놓아두면 계속해서 크기가 커져서 어떨때는 시스템에 지장을 주기도 한다. 하지만 관리자의 입장에서 이 골치덩어리들을 조금만 신경써서 손봐준다면, 위에서 궁금해 했던 질문에 대한 해답을 주는 자료들을 만들어 낼 수 있다.
WWW 관리자들이 Log file 들에 관심을 가져야 하는 이유는 아래와 같다.
Tracking usage 라는 것은 간단히 말하면 얼마나 많은 사람들이 특정한 Site 를 방문했고, 방문한 동안 얼마나 오래동안 머물렀으며 어떤 page 가 가장 유명한가를 나타내주는 자료를 나타내고, Profiling User 는 나이, 성, 직업, 교육정도 같은 사회 경제적인 자료들을 가지고 있는 사용자들를 나타낸다. Log 를 분석하기 위해서 알아야하는 기본적인 몇개의 어휘에 대해서 짚고 넘어가자.
Server 의 처리사항은 아래와 같은 Code 로 Log file 에 저장된다.
hollywood.cs.washington.edu - - [09/Sep/1996:08:59:28 +0900] "GET /~shkim/persona
l.htm HTTP/1.0" 200 167
robot.taegu.ac.kr - - [09/Sep/1996:09:09:18 +0900] "GET /~shkim/ HTTP/V1.0" 200 3
312
magicweb.dacom.co.kr - - [09/Sep/1996:09:10:05 +0900] "GET /www/health.html HTTP/
1.0" 200 11054
magicweb.dacom.co.kr - - [09/Sep/1996:09:14:25 +0900] "POST /cgi-bin/nhealth.pl H
TTP/1.0" 200 1436
pjk.kaist.ac.kr - - [09/Sep/1996:09:15:08 +0900] "GET /~loveiris/ost.html HTTP/1.
0" 200 3208
cust57.max5.portland.or.ms.uu.net - - [09/Sep/1996:09:50:46 +0900] "GET /ktmp95/i
cons/dots/or_diam.gif HTTP/1.0" 200 0
대부분의 Log file 은 호스트 이름으로 나오지 않고 IP address 로 나오는 경우가 더 많게 된다. 이런 경우는 Log file 을 분석하는데 상당히 어려움을 겪을 수가 있다. 그러므로 자신이 분석해야할 Log file 에 IP address 가 많이 나와있다면 Unresolved IP address 를 처리해 주는 기능이 있는 Analyzer 를 이용해야 할 것이다.
[Wed Oct 16 12:54:18 1996] httpd: send aborted for simac.kaist.ac.kr
[Wed Oct 16 13:03:11 1996] httpd: send aborted for martingale.kaist.ac.kr
[Wed Oct 16 13:03:11 1996] httpd: send aborted for simac.kaist.ac.kr
[Wed Oct 16 13:03:15 1996] httpd: send aborted for 203.231.224.100
[Wed Oct 16 13:05:52 1996] httpd: access to /home1/grad/jkhong/Home/icon
   /lipurple.gif failed for 165.246.11.96, reason: file does not exist from
   http://ktmp.kaist.ac.kr/~jkhong/Sports.html
[Wed Oct 16 13:06:50 1996] httpd: send aborted for 168.126.246.120
http://ktmp.kaist.ac.kr/~shlee/ -> /~shlee/bullet2.gif
http://ktmp.kaist.ac.kr/~shlee/ -> /~shlee/note.gif
http://ktmp.kaist.ac.kr/~shlee/ -> /~shlee/bullet5.gif
http://ktmp.kaist.ac.kr/~shlee/ -> /~shlee/cals.htm
Mozilla/2.01 (Win16; I)
Mozilla/2.0 (X11; I; SunOS 4.1.3-KL sun4m)
Mozilla/3.0b5a (Win95; I)
WinPlay3
Mozilla/2.0 (compatible; MSIE 3.0; Windows 95)
Mozilla/3.0 (Win95; I)
SimBot/1.0
Mozilla/2.02 (X11; I; HP-UX A.09.05 9000/712)
Mozilla/2.0 (compatible; MSIE 3.0; Windows 95)
Mozilla/2.02 (X11; I; HP-UX A.09.05 9000/712)
Mozilla/2.0 (X11; I; SunOS 4.1.3-KL sun4m)
대부분의 Freeware Log analyzer 는 access log 를 제외한 다른 log 화일들을 무시하지만 상용 software 의 경우에는 모든 log 화일들을 다각적으로 분석하여 더 많은 정보를 유추해 낼 수 있다.
여러개의 Log Analyzer 중에서 가장 성능 (URL: http://www.uu.se/Software/Getstats/Performance .html") 이 뛰어나고, 사용이 가장 간편한 프로그램이며, CERN, NCSA, GN, MacHTTP 서버들의 Log file 들을 분석할 수 있다.
또한 getstats 는 Public Domain Program 이 아니지만 프로그램을 수정하지 않은 한 자유롭게 배포하여 사용할 수 있도록 되어있음을 알아두어야 한다.
% gcc getstats.c -o getstatsCompile 을 하기전에 getstats.c 의 앞부분에 나오는 여러가지 Option 들을 분석하고자 하는 시스템에 맞게 고쳐주면 분석 작업을 더 편하게 할 수 있다. 이에 대해서는 언급된 문서들이 많으므로 생략하도록 한다.
1. getstats -c (consise report)
getstat 를 실행시켰을때 항상 출력되는 기본적인 통계자료들이 출력된다.
2. getstats -m (monthly report)
서버 사용량을 한달 단위로 구분해서 보여준다.
3. getstats -w (weekly report)
서버 사용량을 한주 단위로 구분해서 보여준다.
4. getstats -d (daily report)
서버 사용량을 하루 단위로 구분해서 보여준다.
5. getstats -dn (domain report)
도메인 이름에 따른 접속 현황을 보여준다.
6. getstats -dt (directory tree report)
각각의 디렉토리마다 마지막으로 접속된 날짜와 접속 횟수를 보여준다.
7. getstats -ip (IP look up report)
Log 화일에 기록된 Client 들이 호스트 이름이 아닌 IP address 로 나와있을때
IP address 를 가지고 호스트 이름을 찾아서 분석해 주는 역할을 한다. 시간은
오래 걸리지만 Log 화일에 IP address 로 남아있는 것이 더 많은 경우에는
유용하게 쓰일 수 있다.
% getstats -c -l access_log -N -M
HTTP Server General Statistics
Server: http://www.eit.com/ (NCSA Common)
Local date: Wed Oct 16 07:02:53 AM GMT 1996
Covers: 09/09/96 to 10/16/96 (38 days).
All dates are in local time.
Requests last 7 days: 31105
New unique hosts last 7 days: 1233
Total unique hosts: 6519
Number of HTML requests: 33576
Number of script requests: 5332
Number of non-HTML requests: 144546
Number of malformed requests (all dates): 56638
Total number of all requests/errors: 240092
Average requests/hour: 268.7, requests/day: 6448.3
Running time: 65 minutes, 19 seconds.
그럼 위의 결과를 하나씩 살펴보도록 하자.
분석에 사용된 access_log 화일은 지난 9월 9일부터 10월 16일 까지 38일동안 기록된 것이라는것을 알 수 있고, 최근 7일 동안 접속한 새로운 호스트들이 전체 6500 여개의 호스트중에서 1233 개를 차지하고 있으므로 지난 1주일동안 새로운 곳에서의 접속이 증가하였음을 알 수 있다.
잘못된 요구가 들어온 것이 전체의 약 25% 정도 되므로 ktmp 서버는 앞으로 Error Document 를 정비해야 할 필요가 있다고 판단된다. 또한, HTML 에 대한 요구보다는 다른 서비스에 대한 요구가 많은 것으로 나타났다. 즉, HTML 문서에 대한 사용자들의 흥미가 적다는 것을 보여준다고 할 수 있으므로 HTML 문서를 재정비할 필요성도 어느 정도 있다고 생각된다.
----------------------------------------------

HTTP Server Domain Statistics
Covers: 09/09/96 to 10/16/96 (38 days).
All dates are in local time.
1 level, sorted by number of requests, 45 unique domains.

# reqs : # uniq : Last Access (M/D/Y) : Domain
----------------------------------------------

85400 : 1246 : 10/16/96 : .kr
81612 : 3886 : 10/16/96 : (numerical domains)
 9400 :  427 : 10/16/96 : .net
 2360 :  357 : 10/16/96 : .com
 2039 :  203 : 10/16/96 : .edu
  357 :   54 : 10/15/96 : .jp
  321 :   48 : 10/15/96 : .au
  285 :   35 : 10/15/96 : .se
  269 :   51 : 10/16/96 : .ca
  241 :   28 : 10/16/96 : .uk
  121 :   18 : 10/15/96 : .org
  113 :    8 : 10/16/96 : .fr
  101 :    6 : 09/30/96 : .sg
   98 :    8 : 10/16/96 : .mil
   94 :   20 : 10/15/96 : .de
   93 :   15 : 10/15/96 : .no
   78 :   14 : 10/10/96 : .fi
   64 :   13 : 10/15/96 : .nl
   48 :    4 : 10/15/96 : .cl
   44 :    8 : 10/15/96 : .us
   40 :    3 : 10/10/96 : .ie
   37 :    9 : 10/07/96 : .nz
   35 :    8 : 10/12/96 : .gov
   30 :    4 : 10/12/96 : .br
   29 :    4 : 09/19/96 : .es
   26 :    4 : 10/01/96 : .is
   24 :    5 : 10/04/96 : .my
   20 :    1 : 10/05/96 : .ar
   16 :    1 : 10/07/96 : .kw
   14 :    4 : 10/10/96 : .il
   10 :    1 : 09/17/96 : .gr
    6 :    1 : 10/16/96 : unknown_host
    5 :    5 : 10/15/96 : .za
    4 :    3 : 09/30/96 : .in
    4 :    4 : 09/26/96 : .hk
    3 :    1 : 10/04/96 : .si
    3 :    2 : 10/03/96 : .pt
    2 :    2 : 10/02/96 : .be
    2 :    2 : 09/26/96 : .it
    1 :    1 : 10/12/96 : .at
    1 :    1 : 10/09/96 : .pe
    1 :    1 : 10/08/96 : .cz
    1 :    1 : 09/18/96 : .ch
    1 :    1 : 09/12/96 : .id
    1 :    1 : 09/11/96 : .dk

----------------------------------------------
역시 .kr 도메인에서의 접속이 가장 많은 것으로 나타났고, 의외로 .edu 나 .com,
.net 도메인에서의 접속이 상당부분을 차지하고 있다는 것을 보았을때 외국에서의
접속도 어느 정도 이루어지고 있다고 봐야한다. 즉, ktmp 의 WWW Home page 가 영어로 되어 있지 않다면 영어로 된 Home page 를 만들어야 할 필요성이 대두된다고 할 수 있다.
HTTP Server Daily Summary
Covers: 09/09/96 to 10/16/96 (38 days).
All dates are in local time.

Each mark (#) represents 100 requests.
----------------------------------------------

   Mon: 28953 : ##########################################################||###
   Tue: 39587 : ##########################################################||###
   Wed: 33223 : ##########################################################||###
   Thu: 24582 : ##########################################################||###
   Fri: 23446 : ##########################################################||###
   Sat: 21049 : ##########################################################||###
   Sun: 12614 : ##########################################################||###

----------------------------------------------
위의 요일별 접근 횟수 분석 결과를 보면 다른 요일에 비해서 화요일에 접속을 많이 하고 있음이 나타난다. 그러므로 Web 관리자는 화요일에 서버 실패가 나타나지 않게 신경을 써야 할 것이고, 유지보수 등도 화요일을 피해서 하는 것이 나을 것이다.
위에서 몇가지 분석 결과에 대해서 유추할 수 있는 간단한 사실에 대해서 알아보았다. 위에서 기술한 유추한 사실이 외에도 다른 많은 사실들을 유추해 내어 Web 서버 관리자 가 더 좋은 서비스를 하기위해서 이용할 수도 있을 것이다.
또한 Agent_log, Error_log, Referrer_log 등의 화일들을 분석하여 Access_log 분석 결과와 연관을 시킴으로서 새로운 정보를 얻어낼 수도 있을 것이다.
결론적으로 Log file 들을 그대로 쌓아두기만 해서 시스템의 자원을 차지하는 짐으로 만들것이 아니라 이를 효율적으로 관리하여 Web 서버가 더 좋은 서비스를 제공하는데 도움이 되도록 이용하는 것이 바람직하다 할 것이다.
앞으로 최신의 정보나 잘못된 사항이 있으면 수시로 고쳐나갈 계획이고 이 문서에
대한 Comment 는 언제든지 환영하며 loveiris@ktmp.kaist.ac.kr 로 보내면 된다.
Update 된 문서의 URL 은 다음과 같다.
http://ktmp.kaist.ac.kr/~loveiris/seminar/A22.html