Robot agents and Search Engine
대전 광역시 유성구 궁동 220
충남대학교 컴퓨터공학과 데이타베이스 연구실
E-mail : bluefrog@flower.comeng.chungnam.ac.kr
URL :
http://flower.comeng.chungnam.ac.kr/~bluefrog/
- Abstract:
- 인터네트 상에 산재한 정보가 방대해지고 WWW가 급격히 발전하면서 사용자들은 정보검색 도구(tool)로서 서치엔진(search engine)을 많이 이용하고 있다. 현재 전 세계적으로 많은 서치엔진들이 동작하고 있고, 각종 정보에 대한 데이타베이스를 구축하고 있고 계속적으로 갱신함으로써 사용자에게 최신의 정보를 제공한다. 서치엔진은 로봇 에이전트(Robot agents)라는 웹(Web)을 순회(traverse)하는 프로그램에 의해 정보를 수집한다. 로봇 에이전트는 지정한 URL을 순회하며 각 홈페이지들의 정보를 수집하고 수집된 정보에 대해서 서치엔진은 사용자가 편리한 방법으로 검색할 수 있는 인덱스를 제공한다.
본 발표에서는 로봇 에이전트의 종류와 동작원리, 기본적인 구조에 대하여 살펴보고 서치엔진이 이 로봇 에이전트를 이용하는 방법에 대하여 설명하고 후반부에는 일일이 많은 서치엔진을 검색할 필요없이 여러 서치 엔진들을 동시에 검색할 수 있는 웹 메타서치엔진의 구현에 대해서 설명하도록 한다.
- Keywords:
- SPIDER, Robot agents, 서치 엔진(Search Engine)
1. 서론
최근에 인터네트(Internet)의 정보의 양과 종류, 정보 제공자의 수는 급속도로 증가되고 있는 추세이다. 이런 방대한 정보를 갖고 있는 인터네트에서 개인이 필요로 하는 정보를 손쉽게 찾는다는 것은 상당히 어려운 일이 되었다. 특히 최근 들어 하이퍼텍스트(Hypertext) 형태의 정보 조직 및 브라우징(browsing)이 가능한 WWW(World Wide Web)를 이용하여 정보를 제공하는 사이트(site)가 기하급수적으로 늘어나고 있는 추세이다.
WWW를 이용해서 인터네트 상에 널리 퍼져 있는 정보를 사용자에게 찾을 수 있도록 도와주는 도구를 서치엔진이라 하고 현제 전 세계적으로 많은 서치엔진들이 존재하고 있으며, 각종 정보에 대한 데이타베이스(database)를 구축하고 있고 계속적으로 갱신함으로써 사용자에게 최신의 정보를 제공한다.
서치엔진들은 정보의 보유 측면에서 본다면 대략 두 가지 형태로 나누어 볼 수가 있다.
- 로봇 에이전트(Robot agents)를 통해 자료를 수집하거나 사용자가 정보를 등록하게 함으로써 자기 자신의 데이타베이스를 구축하고 있는 경우
- 다른 서치 엔진에서 보유하고 있는 데이타베이스를 이용하여 사용자에게 서비스를 하는 형태
로봇 에이전트를 이용해 자료를 수집하는 서치엔진의 경우는 자료를 수집하는 로봇 에이전트, 수집된 자료를 저장하는 데이타베이스, 그리고 사용자가 질의(Query)를 했을
때 자료를 검색해주는 IRS(Information Retrieval System : 정보검색 시스템)로
구성된다. 그리고 다른 서치엔진의 정보(데이타베이스)를 이용하는 것을
메타서치엔진이라고 하는데, 메타서치엔진은 전체적으로 질의를 각 서치엔진에 보내는
부분과 검색되어온 결과들에 대해서 통합해서 사용자에게 보여주는 부분으로 구성된다.
본 고의 구성은 2장에서 Prosed Standard for Robot Exclusion에 대해서 설명하고,
3장에서는 로봇 에이전트에 대한 전반적인 사항들에 대해서 알아 보았고, 4장에서는
웹 메타 서치 엔진의 설계 및 구현에 대해서 알아 보았다.
2. A Standard for Robot Exclusion
2.1 필요성
Wanderers 또는 spiders라고도 불리는 WWW 로봇은 WWW상에서 링크된 페이지들은
순환적으로 검색함에 의해 많은 페이지들을 순회(traverse)하는 프로그램이다.
1993년과 1994년에는 여러가지 이유로 WWW 서버에 로봇들이 방문하는
일이 자주 발생해 왔다. 이들 로봇중에서는 빠른 요구(request) 또는 계속적으로
같은 화일을 검색함으로써 서버를 혼란스럽게 하는 일도 있었다.
그리고 적당하지 않은 WWW 서버의 부분들을 검색한다든가 일시적인 정보 또는
부작용(side-effect)을 가질 수 있는 cgi-script를 검색하는 일도 발생해 왔다.
이러한 일들로 인해서 서버의 어는 특정한 부분을 로봇들이 접근하지 못하도록
인식시켜주기 위한 메카니즘을 확립할 필요가 대두되었다.
2.2 방법
한 서버로부터 로봇을 배제하기 위해 사용되는 방법은 서버에 로봇에 대한 접근
정책을 명세하는 화일을 생성하는 것이다. 이 화일은 HTTP를 경유하여 로컬 URL
"/robots.txt"로 접근 가능해야 한다. 이 화일의 내용은 아래에 명세되어 있다.
이 화일 방법은 현존하는 WWW 서버에 쉽게 구현될 수 있기 때문에 선택되어졌고,
로봇들은 단지 한 문서만을 검색함으로써 접근 정책을 알아낼 수 있다.
이 "robots.txt" 화일 방법의 단점은 서버에 있는 개인의 문서 소유자가 아니라
오직 서버 관리자만이 한 리스트를 유지할 수 있다는 것이다. 이것은 문서 소유자의
수만큼 "robots.txt"화일을 구성하도록 하는 내부처리의 의해 해결되어질 수도 있다.
"/robots.txt" URL의 선택에 대한 동기는 다음과 같다.
- 화일이름은 모든 운영체제의 화일이름 제한에 적합해야한다.
- 화일이름 확장은 여분의 서버 구성을 요구하지 않아야 한다.
- 화일이름은 그 화일의 목적을 나타내고 기억하기에 쉬워야 한다.
- 기존의 화일과 충돌이 적어야만 한다.
2.3 포맷
"/robots.txt"의 포맷과 의미는 다음과 같다.
이 화일은 하나 이상의 블랭크 라인(CR, CR/NL, 또는 NL에 의해 끝나는)에 분리되는
하나 이상의 레코드(record)로 구성된다. 각 레코드는 "<field>:<optionalspace><value><optionalspace>" 형태의 라인들을 포함한다. 필드 이름은 대소문자 구별을 하지 않는다.
주석문은 UNIX의 bourne shell의 사용법을 이용해 화일에 포함할 수 있다. 즉, '#'
문자앞의 공백과 그 라인 끝까지 나머지 부분은 주석으로서 무시된다. 주석문만을
포함한 라인은 완전히 무시되고, 레코드 범위로 인식되지 않는다.
레코드는 하나 이상의 User-agent 라인으로 시작하고, 하나 이상의
Disallow 라인이 아래에 설명된 것처럼 따른다. 인식할 수 없는 헤더는
무시된다.
- User-agent
-
이 필드의 값은 로봇의 이름이고 그 로봇들에 대한 접근 정책을 나타낸다.
하나 이상의 User-agent 필드가 존재한다면 그 레코드는 하나이상의
로봇들에 대해서 동일한 접근 정책을 나타낸다. 적어도 한 레코드당 한 필드는
존재해야될 필요가 있다.
그 로봇은 이 필드를 자유롭게 해석할 수 있고 버전 정보없이 이름의 대소문자
구별없는 부분문자열 매치가 권장되어진다.
만약 값이 '*'라면 그 레코드는 다른 레코드서 매치되지 않는 로봇들에 대한
디폴트 접근 정책을 나타낸다. "/robots.txt"화일에 두 개의 그러한
레코드는 허락되지 않는다.
- Disallow
-
이 필드의 값은 방문되어질 수 없는 부분 URL을 명세한다. 이것은 전체 패스일 수도
있고, 부분 패스일 수도 있다. 이 값으로 시작하는 URL은 검색되어질 수 없다.
예를 들면,
Disallow: /help 는 /help.html 과
/help/index.html 모두에게 검색이 허락되지 않는다. 반면에,
Disallow: /help/ 는 /help/index.html 은 검색이
허락되지 않지만, /help.html 은 검색이 허락된다.
특정한 값을 지정하지 않으면 모든 URL들이 검색되어질 수 있다는 것을 나타낸다.
적어도 하나의 Disallow 필드가 한 레코드에 존재해야 한다.
빈 "/robots.txt"는 명시적인 의미를 가지고 있지 않음을 나타내고,
그것이 존재하지 않는 것으로서 간주될 수 있다. 즉, 모든 로봇들을 환영한다고
고려하면 될 것이다.
Examples
다음 예는 "/robots.txt"화일이 로봇들이 "/cyberworld/map/" 또는 "/tmp/"로
시작하는 URL을 방문하지 못하도록 명세한다.
# robots.txt for http://www.site.com/

User-agent: *
Disallow: /cyberworld/map/  # This is an infinite virtual URL space
Disallow: /tmp/		    # these will soon disappear
아래의 예는 "/robots.txt"화일이 "cybermapper"를 제외한 모든 로봇들이
"/cyberworld/map/"로 시작하는 URL을 방문하지 못하도록 명세한다.
# robots.txt for http://www.site.com/

User-agent: *
Disallow: /cyberworld/map/  # This is an infinite virtual URL space

# Cybermapper knows where to go.
User-agent: cybermapper
Disallow:
아래의 예는 모든 로봇들이 이 사이트를 방문하지 못하도록 한다.
# go away
User-agent: *
Disallow: /
3. 로봇 에이전트와 서치 엔진
3.1 로봇 에이전트의 사용
로봇들은 다음과 같은 많은 유용한 일들을 수행하는데 사용할 수 있다.
- 통계 분석
-
로봇의 목적중의 하나는 웹 서버를 발견하거나 서버의 수를 세는데 사용될
수 있다. 서버당 문서의 평균수를 포함해서 어떤 화일 타입의 분포,
웹 페이지들의 평균 사이즈, 상호 연결성의 깊이 등 통계를 내는데 사용될
수 있다.
- 유지보수(Maintenance)
-
하이퍼텍스트 구조를 유지하는데 주된 어려움중의 하나가 다른 페이지에
대한 레퍼런스가 "죽은 링크(dead links)"가 되는 것이다. 이러한 경우는
레퍼런스 되어지고 있는 페이지가 옮겨졌거나 없어졌을 때 발생한다.
현재 이런 변화에 대해 자신을 참조하고 있는 페이지들의 관리자에게 미리
알려주는 일반적인 메카니즘은 없다.
MOMSpider와 같이 레퍼런스를 입증(verify)하는 로봇은 이들 죽은 링크(dead
links)를 찾는데 도울 수 있고, 하이퍼텍스 구조의 유지보수에 도움을 줄
수가 있다. 로봇들은 구조뿐만 아니라 내용을 유지하는데 도움을 줄 수
있지만 일반적인 것은 아니다.
- 미러링(Mirroring)
-
미러링은 FTP 아카이브(archives)를 유지하는 일반적인 테크닉이다. 미러는
FTP에 의해서 순환적으로 디렉토리 트리를 완전히 카피하고,
변화된 문서들을 검색한다. 이것은 호스트 파손(host failure)에 대비하기
위해서 공유와 중복에 대한 로드(load)를 허락하는 것이고 보다 빠르고
값싼 접근, 오프-라인(off-line) 접근을 허락한다.
웹에서의 미러링은 로봇으로 구현될 수 있다. 로봇들은 웹 페이지들의 서브
트리를 검색할 수 있고 로컬에 저장할 수 있지만 단순히 변화된 페이지들을
수정(update)하는 용도가 아니다. 웹에서의 카피된 페이지들은 레퍼런스가
다시 쓰여져야 할 필요가 있을 수 있고, 또 상대적으로 쓰여진 레퍼런스의
경우 절대 링크로 변환되어져야 한다. 성능상의 이유로 미러링 도구(tool)에
대한 요구는 많이 감소되고 있다.
- 리소스 발견
-
아마도 로봇들의 가장 흥미있는 애플리케이션은 리소스 발견의 사용에 있다.
사람이 처리할 수 없는 막대한 양의 정보에 대해 컴퓨터가 하도록 하는
것은 흥미있는 것이고 실제로 몇몇 로봇들은 웹의 많은 부분을 요약하고
있고 서치 엔진을 통해서 이들 결과를 가지고 있는 데이타베이스에
접근을 제공한다.
이것은 단순히 브라우징에 의존하기 보다는 웹 유저가 정보를 찾는데
브라우징과 서칭을 함께할 수 있다는 것을 의미한다. 심지어 데이타베이스가
유저가 검색하기 원하는 정확한 아이템을 포함하고 있지 않다 하더라도
관련있는 페이지들에 대한 레퍼런스를 포함하고 있을 것이고 유저는
차례대로 그 아이템들을 참조할 수 있다.
이것의 장점중의 하나는 주기적으로 자동적으로 데이타베이스가 갱신되고,
데이타베이스에서 죽은 링크(dead links)는 발견되어지고 제거될 것이다.
- 복합적인 사용
-
한 로봇은 위의 일중에서 하나 이상의 일을 수행할 수 있다. 예를 들면
RBSE Spider는 리소스 발견 데이타베이스(resource discovery database)를
제공할 뿐만 아니라 검색된 문서들의 통계분석을 한다. 이러한 복합적인
사용은 불행스럽게도 아직 드문 상태이다.
3.2 로봇의 순회방법
- 넓이-우선 순회(breadth-first traversal)
-
상위 레벨에서부터 제한된 깊이까지 보다 넓은 그리고 상위 레벨의 문서와
서비스의 집합을 찾는데 좋다. 즉, 한 다큐먼트에 여러 레퍼런스가 있을
경우 개개 레퍼런스들에 대해서 먼저 검색을 하고 그 다음 한단계 깊이
들어가 검색하는 방법으로서 리소스 발견을 위해서 훨씬 더 좋은
방법이다.
- 깊이-우선 순회(depth-first traversal)
-
순회로서 새로운 사이트를 찾는데 보다 좋다. 이 방법은 한 다큐먼트에
여러 레퍼런스가 있을 경우 한 레퍼런스에 대해서 계속 따라가면서 검색하는
방법이다.
3.3 서치 엔진에서의 로봇의 이용
서치 엔진에서 자료를 수집하고 인덱싱하는데 로봇 에이전트를 이용할 수 있다.
이것은 로봇의 이용 방법중 리소스 발견 측면인데, 서치 엔진이 로봇을
동작시켜서 검색된 정보들을 데이타베이스에 저장하고 인덱싱해서 사용자들이
질의를 통해 데이타베이스로부터 정보를 검색할 수 있게 한다.
서치 에진은 로봇을 주기적으로 동작시켜서 변화된 정보를 갱신하고 새로운
정보를 데이타베이스에 저장한다.
3.3.1 문서 요약
임의의 웹 문서를 인덱스하기는 매우 어렵다. 초기의 로봇들은 문서 타이틀과
앵커(anchor) 텍스트를 간단히 저장했다. 하지만 새로운 로봇들은 보다 진보된
메카니즘을 사용하고 내용 전체를 고려한다.
이들 방법들은 일반적으로 좋은 수단이고, 모든 웹 페이지들에 자동적으로 적용되어질
수 있다. 그렇지만 손으로 인덱싱한 것 만큼 효율적일 수 없다. HTML은 <META>
를 명세함에 의해 문서에 일반적인 메타 정보를 덧붙일 수 있는 기능을 제공한다.
예를 들면, "<meta name="Keywords" value="Ford Car Maintenance">와 같다.
그러나, 이 태그(tag)의 애트리뷰트의 명세된 값에 대해 의미가 정의되어 있지
않기 때문에 그것을 받아들일 것인지와 그것의 사용여부에 대해서는 엄중히 제한된다.
이것은 질의와 관련해서 검색된 문서들을 본다면 낮은 "정확도"를 나타낸다. 불리안
연산자(Boolean Operators), WAIS와 같은 가중화된 매치(Weighted match) 또는
relevance feedback과 같은 진보된 방법은 낮은 정확도를 개선할 수 있지만 인터넷
상의 정보가 막대하게 다양해지므로 이 문제는 계속될 것이다.
4. 웹 메타 서치 엔진의 설계 및 구현
전 세계적으로 산재한 서치 엔진들은 그 수가 많아짐에 따라 일관되지 못한 정보를
제공하고 있거나 어느 특정한 곳에 집중된 전보를 제공하는 경우도 있어 사용자가
원하는 정보를 얻기 위해서는 많은 서치 엔진들을 일일이 조사해야 하고 각각의
서치 엔진들의 특성을 알아야 하는 불편함 점이 있다.
따라서 본 고에서는 사용자가 많은 서치 엔진들을 일일히 검색할 필요없이 서치
엔진들을 통합하여 보다 쉽게 사용할 수 있도록 사용자에게 일관된 인터페이스 및
질의를 제공하고 질의에 대하여 가능한 많은 검색 결과를 통일된 형태로 제공할 수
있는 웹 메타 서치 엔진의 설계와 구현에 대해서 알아보기로 한다.
4.1 웹 메타 서치 엔진의 설계시 고려 사항
4.1.1 질의의 형태
웹 메타 서치 엔진은 어느 특정 엔진과는 독립적인 새로운 질의 형태를 정의하였는데,
그 이유는 사용자가 보다 편리하고, 일관성있는 질의를 사용할 수 있도록 하고, 본
시스템이 대상으로 하고 있는 각기 다른 질의 형태를 가진 서치 엔진들과 독립적인
투명성(transparancy)을 제공하기 위해서이다.
본 시스템의 질의에서는 불리안 연산자(boolean operator)를 지원하는데, 누구든지
쉽게 사용할 수 있고, 사용자의 의도를 정확하게 나타낼 수 있고, 본 시스템에서
정보 수집의 대상으로 하는 서치 엔진들에 적용하기 쉽기 때문이다. 본 시스템에서의
질의의 예는 "Multimedia and Hypermedia or Database"일 수 있다.
4.1.2 질의 처리 방안
본 시스템에서는 정보의 수집을 다른 서치 엔진들에 의존하기 때문에 시스템에서
입력받은 질의에 대해 다른 엔진들에 적합한 형태로 바꾸어 주어야 할 필요가 생긴다.
질의의 처리 과정은 먼저 질의를 입력 받고 질의의 정당성 검사를 포함한 분석이
이루어지고 각 서치 엔진별로 쓰래드를 생성한다. 쓰래드에서 각 서치 엔진의 특성에
맞는 질의를 만들어 내고 대상 서치 엔진에 질의를 수행하고 검색 결과를 통합해
사용자에게 보여준다.
질의의 형태는 두가지가 있을 수 있다.
- 단일 텀으로 질의를 하는 방법
- 연산자까지 포함해 질의를 하는 방법
단일 텀을 대상 서치 엔진에 질의의 형태로 보내는 방법은 대상 서치 엔진에서
문서들에 우선 순위를 적용하는 랭킹(ranking)기법을 활용할 수 없다는 단점이 있기
때문에 사용자에게 보다 정확한 결과를 보여주기 위해서 본 시스템에서는 서치 엔진의
특성이라 할 수 있는 랭킹 기법을 충분히 활용하는 질의문을 거의 수정없이 대상 서치
엔진에 질의하는 방법을 사용한다.
4.1.3 성능 향상을 위한 고려 사항
본 시스템에서는 여러 대상 서치 엔진에 질의를 해서 얻어진 결과를 합병하는 방법을
사용하는데, 여러 대상 서치 엔진들이 있을 때 엔진들 각각에 질의를 할 수 있는
방법은 두가지가 있을 수 있다.
- 같은 질의를 각 엔진에 대해서 하나씩 하나씩 하는 형태
- 각 대상 서치 엔진들에 동시에 질의를 하는 방법
하나의 대상 서치 엔진에 질의하는 시간에 여러 개의 서치 엔진에 질의를 해볼 수
있는 성능상의 장점때문에 본 시스템에서는 두번째의 방법을 사용한다.
이와같이 시스템의 효율을 높이기 위해서 여러 대상 엔진들에 동시에 질의하는 방법을
사용하는데 있어서도 여러가지 구현 방법이 있을 수 있지만 본 시스템에서는
멀티쓰래드(multi-thread)를 사용한다. 기존에 멀티쓰래드 라이브러리가 이미
존재해서 구현이 용이하고, Linght-Weight Process를 사용함으로써 메모리 관리 측면
등 시스템을 효율적으로 사용할 수 있기 때문이다.
4.2 웹 메타 서치 엔진의 설계
4.2.1 전체 시스템의 설계
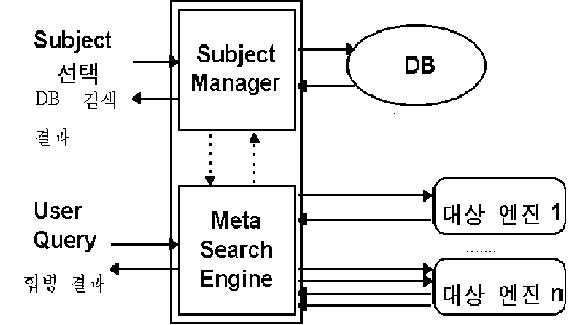
[그림 1 웹 메타 서치 엔진의 전체 블럭도]
그림 1은 웹 메타 서치 엔진의 전체 블럭도이다. 본 시스템은 사용자가 직접 질의문을
선택함으로써 질의를 하는 형태와 주제어(subject)를 선택함으로써 질의를 하는
형태로 두가지로 질의를 할 수가 있다. 결과를 사용자에게 보여줄 때는 주제어를
선택했을 경우 자체 데이타베이스에 저장된 정보를 이용하고 사용자 질의의 경우는
여러 서치 엔진들로부터 그때 그때 정보를 수집한다.
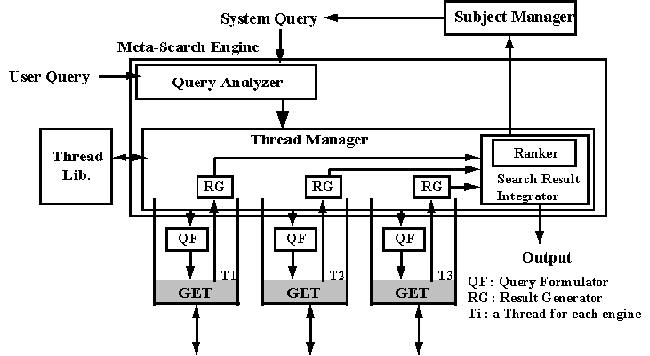
[그림 2 Meta-Search Engine의 블럭도]
웹 메타 서치 엔진은 전체적으로 두 부분으로 나뉘어진다. 첫째는, 사용자의 질의를
입력받아 처리하는 메타서치엔진(Meta-Search Engine)부분(그림 2)이고, 다음은
주제에 대해서 관리를 수행하는 주제 관리자(Subject Manager)부분(그림 3)이다.
본 시스템의 전체적인 적업 처리는 질의의 입력, 질의의 처리(정당성 검사, 질의분선), 대상 서치 엔진에의 질의, 점수의 정규화(normalization), 합병과 재랭킹과 같은
일련의 순서를 통해서 이루어지고, 각 처리 단계마다 작업을 처리할 수 있는 구성
요소(Component)를 갖는다.
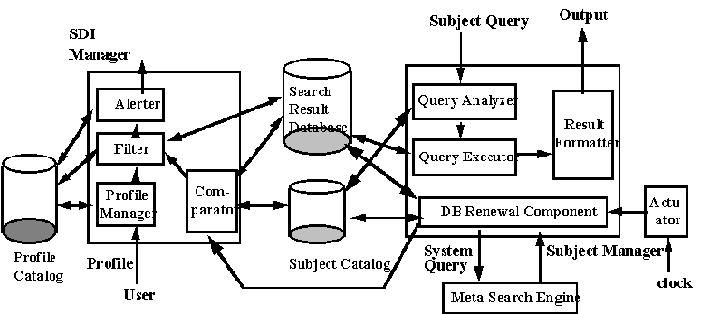
[그림 3 SDI Manager와 Subject Manager의 블럭도]
4.2.2 각 모듈별 설계
- 메타 서치 엔진(Meta-Search Engine)
-
메타 서치 엔진은 본 시스템에서 핵심이 되는 부분으로서 사용자 질의의 처리
및 데이타베이스에 저장되는 정보의 수집을 담당한다.
질의 분석기(Query Analyzer)는 질의 입력, 질의의 정당성 검사, 질의의 분석
등과 같은 작업을 한다. 그리고 분석된 질의를 쓰래드 관리자(Thread
Manager)로 전달한다.
쓰래드 관리자는 각 대상 서치 엔진에 대한 질의에 대해 처리를 해주는
부분으로 쓰래드 생성, 질의의 변형, 결과의 분석 및 결과의 생성, 결과의
통합 및 재랭킹과 같은 작업을 수행한다. 또 질의문 변형기(Query
Fomulator), 결과 생성기(Result Generator), 결과 통합기(Result
Integrator) 등을 갖는다.
- 주제어 관리자(Subject Manager)
-
주제어 관리자는 사용자가 주제어를 선택함으로써 질의를 할 때 이를
처리하여 주는 모듈이다. 구성 요소로는 질의 분석기(Query Analyzer),
질의 실행기(Query Executor), 결과 생성기(Result Fomatter), DB
변경기(DB Renewal Component) 등을 갖는다.
DB 변경기는 항상 메모리에 상주해 있으면서 데몬(Daemon)의 성격을 가진
Actuator로부터 신호를 받으면 Search Result Database를 새로운 정보로
변경을 하게 된다. 이 때 주제 카탈로그를 참조해서 시스템 질의를 하게
되는데, 변경할 주제를 메타 서치 엔진에 질의하고 결과는 다시 정보
변경기로 들어와 SDI 관리자로 보내지게 된다.
- SDI 관리자
-
SDI 관리자는 사용자가 질의를 하지 않아도 주기적으로 자동적으로 새로운
정보를 등록된 프로파일에 대해서 메일을 통해서 보내주는 역할을 하는
것으로서 프로파일 관리자(profile manager), 비교기(comparator),
필터(filter), 통보기(alerter)등의 구성 요소를 가지고 있다.
4.3 웹 메타 서치 엔진의 구현
4.3.1 질의문 처리를 위한 연산
본 메타 서치 엔진인 CGI 프로그램에서는 질의문을 처리하기 위한 연산으로서 디코드,
분석, 정당성 검사를 하는 루틴들을 제공한다.
디코드 연산은 인코드된 질의문을 읽어 들여 질의문을 디코드하고 디코드된 질의문을
분석하기 위한 분석기를 호출한다. 분석 연산은 질의문의 문자열을 파싱하고 연산자와
텀을 구분하는 작업을 한다. 정당성 검사 연산은 문자열의 수, 텀과 연산자의 배열
들을 참조해 정당한 질의인가를 판단한다.
4.3.2 쓰래드 관리자의 구현
쓰래드 관리자는 대상 서치 엔진 이름과 시간을 조합해 동시에 여러 사람이 사용할 때
서로 다른 화일명을 가지도록 화일명을 만들고 돌아온 결과에 대해서는 그화일에
저장을 한다. 그리고 POSIX thread 라이브러리를 사용해 쓰래드를 만들고 질의
생성기를 통해서 각 서치 엔진의 특성에 맞는 질의문을 만들고 get라이브러리,
URL, 질의문, 옵션 등을 조합한 질의 스트링을 만들어 시스템 콜을 통해서 대상
서치 엔진에 질의를 한다.
4.3.3 결과 생성기의 구현
각각의 HTML형식의 결과 화일을 분석해 URL, TITLE, WEIGHT 등을 리스트 형태로
오름차순으로 저장한다. 이렇게 얻어진 결과들은 서치 엔진마다 다른 점수를 가지고
있기 때문에 결과들을 합병하기 위해서는 점수의 정규화가 이루어져야 한다.
본 시스템은 각 서치 엔진마다 다른 점수를 정규화시키기 위해서 Combining Method를
사용하는데, 이 방법은 본 시스템이 대상으로 하는 서치 엔진들의 점수 산출 방법이나
랭킹 방법을 모르기 때문에 사용하는 방법으로서 아래 수식으로 나타낼 수 있다.
	MinMax = (OldSim - MinimumSim) / (MaximumSim - MinimumSim)
	CombinedSum = SUM(IndividualSims)
위 식에서 MaximumSim은 결과에서 가장 높은 점수, MinimumSim은 가장 낮은 점수,
OldSim은 현 점수를 나타내는데, 현 점수는 결과를 통합하기위해서 MinMax 값으로
대체되어진다. 그리고 각각의 서치 엔진의 점수(IndividualSims)를 더해서
CombinedSum값을 정규화된 점수로 얻는다.
4.3.4 결과 통합기의 구현
본 시스템은 InfoSeek, Lycos, WebCrawler, AliWeb 등 4개의 서치 엔진에 질의를
해서 결과를 수집하는데, 결과를 통합하기 위해서 각각의 서치 엔진에서 나온
결과들에서 같은 URL이 있으면 제거하고 점수로서 CombinedSum값을 갖는다.
이렇게 얻어진 결과는 URL로 정렬된 결과이기 때문에 다시 점수순으로 정렬하여
사용자에게 보여 준다.
4.3.5 주제어 관리자의 구현
주제어 관리자의 주된 역할은 주제어 질의를 처리하고 데이타베이스를 새로운 정보로
갱신시키는데, 데이타 저장 메카니즘을 보면 데이타가 데이타베이스를 사용할 만큼
많은 데이타가 아니고 오히려 오버헤드가 될 수 있으며 일반 화일의 사용이 구현하기
쉽게 때문에 데이타를 저장하는 메타니즘으로 화일을 사용한다.
그리고 여러 개의 단어를 가진 주제어에 대한 처리는 AND 연산자로 단어들을 연결하는
방법을 사용하였다.
5. 결론
현재 인터네트는 정보의 양이 방대해지면서 사용자가 원하는 정보를 정확히 손쉽게
찾고자 하는 노력도 커져서 웹을 이용한 서치 엔진과 로봇 에이전트가 나타나게
되었고 서치 엔진을 이용하지 않고 원하는 정보를 찾는다는 것은 사실상 어려운 일이
되었다.
본고에서는 인터네트 상에서 정보를 찾는 도구인 서치 엔진과 웹에서 각 홈페이지의
정보를 수집하는 프로그램인 로봇 에이전트에 대해서 서버 관리자와 개발자 측면에서
알아 보았고 다른 서치엔지들의 정보를 이용하는 메타서치엔진의 설계와 구현에
대해서 알아 보았다.
참고문헌(References)
[1] "http://info.webcrawler.com/mak/projects/robots/robots.html", World Wide Web Robots, Wanders, and Spiders
[2] 박정훈, "인터네트 정보 자원 데이타베이스 구축 및 정보 발견 시스템 개발", 최종연구보고서, 시스템공학연구소, 1995. 7
[3] 박정훈, 조현성, 이강찬, 이규철, "인터네트 정보 발견 시스템의 개발 및 구현",
정보과학회 논문
[4] Joon Ho Lee, "Combining Multiple Evidence from Different Properties of Weighting Schemes", Cornell University
[5] 한국전자통신연구소, 기술정보센터, "멀티쓰래딩 기법과 동향(I, II)", 주간 기술동향 93-30,31, 1993