김상욱
한국 컴퓨터 통신 (주)
E-mail : cygnus@kcom.co.kr
URL : http://grigg.chungnam.ac.kr/~cygnus
월드 와이드 웹(WWW: World-Wide Web)은 스위스의 CERN에서 개발된 하이퍼미디어 방식의 대규모 정보 서비스 시스템으로서, 1992년 발표된 이후 인터넷을 중심으로 급속히 성장하여, 현재는 상업적인 응용에 사용되고 있기도 하다 [3, 5].
기존의 하이퍼미디어 시스템들이 사용자 접속 도구나 편집 기술 및 자료 저장 기법에 치중하여 개발된 반면 WWW은 전세계에 광범위하게 퍼져 있는 여러 형식의 자료를 정보 서비스 환경에 접목시키는 데 촛점을 두었다. 이를 위하여 다음과 같은 근본적인 문제를 해결하고 있다.
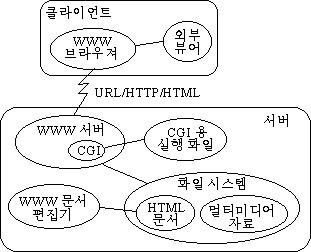
< 그림 1 > WWW의 구조
< 그림 1 > 는 WWW의 구조를 간략하게 나타낸 것이다. WWW에서는 정보가 멀티미디어 자료나 다른 문서를 링크로 갖는 하이퍼미디어 문서로 표현된다. 클라이언트의 WWW 브라우져는 개별 하이퍼미디어 문서를 번역하여 사용자 화면에 실연(presentation)한다. 이때, 각 멀티미디어 자료의 실연을 위해 적절한 외부 뷰어(external viewer)를 이용하기도 한다. 예를 들면, MPEG 방식의 동화상을 실연하기 위해 mpeg_play라는 명령어를 이용할 수도 있다. WWW 브라우져는 사용자가 원하는 문서의 주소를 식별하여 해당 WWW 서버를 연결한다. WWW 서버는 클라이언트의 요구에 의해 화일 시스템에 저장된 하이퍼미디어 문서와 여기에 링크된 멀티미디어 자료를 전송한다. 이때, WWW 서버와 WWW 브라우져간에는 HTTP(hypertext transmission protocol) [1]라는 통신 규약이 적용되고. 하이퍼미디어 문서는 HTML(hypertext markup language) [4]라는 언어로 기술된다. 전세계에 퍼져 있는 각 하이퍼미디어 문서 및 멀티미디어 자료는 고유의 식별자인 URL(uniform resource locator) [2]을 갖는다.
WWW 서버는 운영 체제의 일반 프로그램을 호출할 수 있는 CGI(common gateway interface)를 지원한다. 이는 검색, 위치 지정이 가능한 이미지, 폼, 그리고 그때 그때 요구에 따라 생성되는 하이퍼미디어 문서를 다루는 데 자주 이용된다. CGI는 WWW 서버로부터 여러 가지 입력 인자를 환경 변수 형태로 받고, 프로그램 수행 결과를 HTML 문서로 변환하여 WWW 서버에 전달한다 [7].
WWW 기술은 대규모 멀티미디어 정보 서비스 측면에서 다음과 같은 우수성을 가지고 있다.
WWW은 멀티미디어 정보 서비스 시스템으로서 위와 같은 우수성을 갖는 반면, 아직까지 자료의 저장소로서 데이타베이스에 대한 연결을 직접 지원하지 않고 있어, 대량의 자료를 가진 데이타베이스 서비스를 개발하는 데에는 문제가 많다. 예를 들면, 복잡하고 방대한 멀티미디어 자료를 데이타베이스 관리 시스템의 도움 없이 운영 체제의 화일 시스템에 관리한다는 것은 매우 힘들다.
은행의 예입/인출 업무, 항공사의 좌석 예약 업무 등으로 대표되는 클라이언트-서버 데이타베이스 시스템은 크게 세 개의 소프트웨어 모듈로 분리된다. 첫째는 데이타 관리 모듈로서, 특정 응용과 독립되어 데이타베이스의 구축, 검색 등을 지원한다. 일반적으로 DBMS(database management system) 엔진이 여기에 해당한다. 둘째는 응용 업무 모듈로서, 각 업무의 데이타 처리 절차를 구현하고 있다. 예를 들면, 은행의 예입 업무에 대한 응용 업무 모듈은 데이타 관리 모듈을 이용하여 해당 계좌의 잔금을 변경하는 절차를 구현하게 될 것이다. 셋째는 사용자에게 대화형으로 자료를 입력 받고 결과를 출력하는 실연 모듈이다 [6].
클라이언트-서버 데이타베이스 시스템의 구조는 응용에 따라 여러 가지가 있으나, 현재 가장 많이 사용되고 방식은 < 그림 2 > 과 같은 2겹 구조이다 [8].
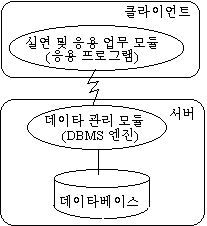
< 그림 2 > 2겹 클라이언트-서버 데이타베이스 시스템 구조
2겹 구조에서 클라이언트의 응용 프로그램은 여러 가지 응용 개발 도구(예를 들면, PowerSoft사의 PowerBuiler)를 이용하여 쉽게 작성할 수 있다. 클라이언트의 응용 프로그램과 서버의 DBMS 엔진을 접속하기 위해서 여러 가지 중간모(middleware)가 사용되기도 한다. DBMS 엔진은 내장절차(stored procedure)라는 기능을 이용하여 응용 업무 모듈의 일부 기능을 수행할 수도 있다.
한편, 앞으로는 응용 업무 모듈을 실연 모듈에서 분리하여 서버에 두고 여러 클라이언트가 공유하는 3겹 구조가 점점 더 많이 사용될 것으로 보인다. 3겹 구조에서는 응용 업무 모듈이 운영 체제, 트랜잭션 처리 모니터, 그리고 기타 관련된 중간모의 도움을 받아 수행되기 때문에 2겹 구조에 비하여 신축성, 확장성, 그리고 대규모 시스템에서 성능이 좋을 것으로 예상되고 있다 [8, 9].
클라이언트-서버 데이타베이스 시스템은 OLTP(on-line transaction processing)와 같은 주문형 서비스를 구축하는 데 매우 적합하다. 주문형 서비스란 사용자가 일정한 양식을 통해 자료를 입력함으로써 트랜잭션을 발생하고, 서비스 시스템은 이 트랜잭션을 데이타베이스에 수행함으로써 업무가 이루어진다. 데이타베이스 서비스는 주문형 서비스보다는 정보 검색 서비스가 주를 이룬다는 면에서 클라이언트-서버 데이타베이스 시스템의 구조가 적합하지 않을 수도 있다.
멀티미디어 데이타베이스 서비스 시스템은 방대한 자료를 데이타베이스로 관리할 수 있는 기능이 있어야 한다. 클라이언트-서버 데이타베이스 시스템의 DBMS 엔진은 이를 위한 많은 기능을 이미 구현하고 있다. 예를 들면, 많은 상용 DBMS가 다음과 같은 기능을 지원하고 있다.
데이타베이스의 접근은 ISO 표준 데이타베이스 언어인 SQL을 통하여 이루어진다. SQL 언어는 비절차적인(non-procedural) 언어로서 데이타베이스의 복잡한 물리적 구조와 관계 없이 질의를 표현할 수 있다. 응용 프로그램 개발자는 일반 프로그래밍 언어에 SQL을 내포하거나, 폼 개발 도구를 이용하여 응용 프로그램을 개발한다. 특히, 폼 개발 도구를 이용하는 것은 생산성이 뛰어난 것으로 알려져 있다.
2겹 혹은 3겹 구조의 클라이언트-서버 데이타베이스 시스템을 멀티미디어 데이타베이스 서비스에 적용하면 데이타베이스가 서버에 해당되고 가입자의 단말기가 클라이언트에 해당될 것이다. 가입자는 클라이언트의 실연 모듈에 의해 정보 서비스를 받게 된다. 멀티미디어 정보의 실연 사양(예를 들면, 화면 배치)은 클라이언트의 응용 프로그램에 코드화 되어 있거나 폼 개발 도구에 의해 작성된 폼 화일에 담겨져 있다. 즉, 응용 프로그램이 수행되거나 폼 화일이 번역되면서 필요한 자료를 서버의 데이타베이스에서 불러와 실연하게 된다. 실연 사양을 응용 프로그램에 코드화하는 방식은 실연 사양 변경이 어렵기 때문에 현실적으로 대규모 데이타베이스 서비스 환경에 적용하는 것은 매우 힘들다. 폼 화일을 이용하는 경우에도 다음과 같은 문제점이 발생한다.
멀티미디어 데이타베이스 서비스에서 자료의 실연은 매우 다양할 수 있다. 예를 들면, 전자 신문의 경우 기사마다 적절한 화면 배치가 다를 수 있다. 반면에 클라이언트-서버 데이타베이스 시스템에서 홈은 응용 업무마다 몇 가지 정형화된 형태를 갖는다. 따라서, 폼을 멀티미디어 데이타베이스 서비스 양식으로 이용하게 되면 매우 많은 종류의 폼이 생성, 관리되어야 할 것이다. 많은 종류의 폼 화일을 클라이언트마다 복사하여 관리하는 것은 비효율적일 수 있다. 특히, 일반적으로 데이타베이스 서비스의 가입자 수는 클라이언트-서버 데이타베이스 환경의 클라이언트 수에 비하여 훨씬 많기 때문에, 폼을 변경하는 것이 매우 어렵게 된다. 이러한 문제점을 없애기 위해서는 폼을 서버에 관리하여 공유하는 구조가 바람직하다.
데이타베이스 서비스 가입자가 항상 같은 종류의 폼 번역기를 운영하고 있다고 가정하기는 어렵다. 서비스 범위가 넓어짐에 따라 가입자 환경은 더더욱 다양해질 것이다. 현재 사용되고 있는 폼 화일의 형식은 국제적인 표준이 없고 사용되는 폼 개발 도구마다 다르다. 클라이언트-서버 데이타베이스 시스템을 광범위 데이타베이스 서비스에 적용할 수 있기 위해서는 홈 화일의 형식에 대한 국제적인 표준이 진행되어야 한다.
앞에서 살펴본 바와 같이, 대규모 멀티미디어 데이타베이스 서비스 시스템은 클라이언트-서버 데이타베이스 시스템의 방대한 데이타베이스 관리 기능과 응용 개발 도구, WWW의 대규모 서비스 구조가 동시에 필요하다. < 그림 3 > 은 WWW와 데이타베이스 시스템의 상호 보완적인 통합의 개념을 표현한 것이다.
멀티미디어 데이타베이스를 DBMS 엔진과 데이타베이스 관리 도구를 이용하여 구축, 관리하고 이를 가입자에게 서비스하기 위해서는 WWW의 구조를 이용한다. 데이타베이스 통로(database gateway)는 이와 같은 통합을 구현하는 핵심 부분이다.
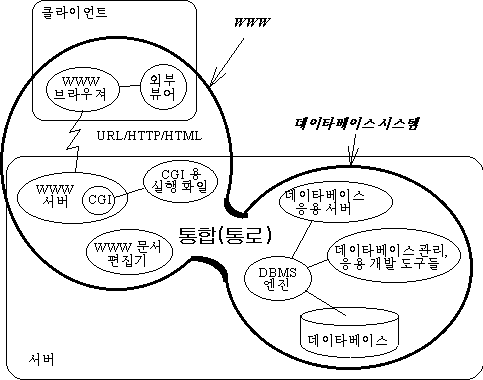
< 그림 3 > 데이타베이스 시스템과 WWW의 통합 개념
위와 같은 상호 보완적인 통합은 클라이언트-서버 데이타베이스 시스템과 WWW에서 다음과 같은 장점을 계승 받게 된다.
이 문서의 구성은 다음과 같다. 2장에서는 WWW와 데이타베이스를 통합하는 핵심 부분이라고 할 수 있는 데이타베이스 통로의 여러 가지 구조에 대하여 설명한다. 3장에서는 이미 구현된 데이타베이스의 통로를 간략하게 조사한다. 4장과 5장에서는 보다 자세한 사례 조사로서, UniSQL/X 객체지향 DBMS에 연결하여 사용할 수 있는 GSQL과 UniWeb 통로에 대하여 설명한다. 그리고, 6장에서는 문서의 결론을 맺는다.
데이타베이스 통로는 WWW와 데이타베이스 시스템을 연결하는 부분이다. 보다 구체적으로는 WWW의 WWW 서버와 데이타베이스 시스템의 DBMS를 연결한다. 즉, WWW 서버는 사용자의 데이타베이스 질의를 데이타베이스 통로를 통하여 DBMS에 전달하고, DBMS의 질의 수행 결과는 다시 데이타베이스 통로를 통하여 WWW 서버에 전달된다.
데이타베이스 통로의 자세한 구조는 구현 방식에 따라 매우 다양하나, 크게 WWW 서버의 CGI를 이용하는 방식과 WWW 서버 자체를 확장하는 방식으로 나누어진다.
데이타베이스 시스템과 WWW의 가장 단순한 통합 방법은 기존의 WWW 서버 및 브라우져를 변경하지 않고 그대로 사용하는 방식으로서, < 그림 4 > 와 같은 구조를 갖는다. 기존의 URL, HTTP, HTML 등을 수정없이 사용할 수 있다.
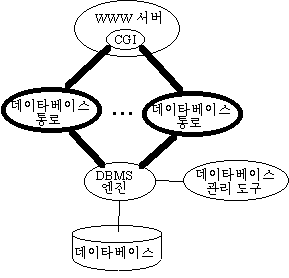
< 그림 4 > CGI를 이용한 데이타베이스 통로의 구조
데이타베이스에 저장된 모든 자료는 데이타베이스 통로를 통해 접근되고, 데이타베이스 통로는 WWW 서버의 CGI를 통하여 입력 인자를 받고, 데이타베이스 엔진을 통해 원하는 자료를 검색한 후, 이를 HTML 문서 형태로 변환하여 WWW 서버에 넘겨준다. 데이타베이스 통로는 DBMS의 기능을 이용하기 위하여 연결하고자 하는 DBMS의 응용 프로그램 개발 도구를 이용하여 작성된다. 예를 들면, ESQL/C, Perl 인터페이스 등이 사용될 수 있다. 즉, DBMS 측면에서 보면 데이타베이스 통로는 하나의 DBMS 응용 프로그램이라고 할 수 있다.
일반적으로 WWW 서버의 CGI와 데이타베이스 통로 사이의 통신은 프로세스 파이프를 이용한다. 즉, WWW 서버는 데이타베이스 통로 프로세스를 생성한 후 프로세스 파이프를 연결하여 데이타베이스 통로 프로세스의 stdout을 결과로 받게 된다.
WWW 서버는 하나의 요구를 처리할 때마다 새로운 데이타베이스 통로 프로세스를 생성하고 파이프를 연결한다. 따라서, 데이타베이스 통로는 하나의 요구를 처리하기 위하여 DBMS에 연결하고 로그인하는 복잡한 과정을 매번 수행해야 한다. 이는 DBMS마다 조금씩 다르나 상당한 시간을 필요로 하는 경우도 있다. 이로 인한 성능 저하를 최소화하기 위하여 데이타베이스 통로를 데몬(daemon) 프로세스 방식으로 관리할 수도 있다. 이 경우에는 CGI가 호출하는 프로세스는 스터브(stub) 형식의 간단한 프로그램으로서, 데몬 프로세스로 되어 있는 데이타베이스 통로에 요구를 전달하는 기능만을 수행하면 된다 ( < 그림 5 > 참조).
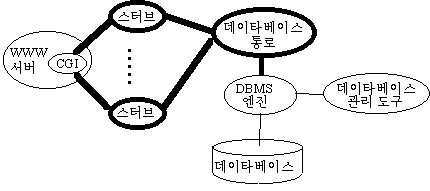
< 그림 5 > 데몬 프로세스로서의 CGI 데이타베이스 통로 구조
WWW 서버의 CGI를 이용한 통합은 다음과 같은 장점을 갖는다.
그러나, 다음과 같은 단점도 갖는다.
WWW 서버의 CGI를 이용한 데이타베이스 통로는 구현이 쉬워, 현재까지 많은 제품이 개발되어 있다. 다음은 이 중 몇가지를 열거한 것이며, 각각에 대한 보다 자세한 내용은 뒤에서 기술한다.
앞에서 기술한 CGI를 이용한 통합 방식의 성능 문제를 해결하기 위하여 WWW 서버로 하여금 데이타베이스 시스템을 직접 접속할 수 있도록 할 수 있다. WWW 서버의 확장에 의한 통합은 기존의 WWW 서버에 DBMS 엔진을 직접 접속할 수 있는 데이타베이스 통로를 추가하는 방식이다. < 그림 6 > 는 이러한 구조를 보인 것이다. 이 방식에서는 WWW 브라우져를 비롯한 URL, HTTP, HTML 문서 등 기존의 WWW 기술을 그대로 이용할 수 있으나 WWW 서버는 확장된 것만 이용할 수 있다.
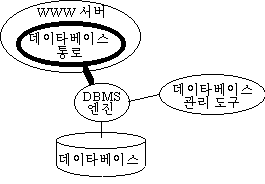
< 그림 6 > WWW 서버의 확장에 의한 데이타베이스 통로의 구조
모든 데이타베이스 접근은 데이타베이스 통로를 통하여 이루어진다. 데이타베이스 통로를 통해 접근되는 데이타베이스 자료를 위해 기존의 URL을 이용한다. 예를 들면, http:// < 호스트명 > / < 경로명 > ? < 질의 > 의 < 경로명 > ? < 질의 > 부분을 이용한다. 데이타베이스 통로를 위한 URL 이용은 기존 URL 사양의 확장이 아니다. 즉, 기존의 WWW 브라우져나 HTML 표준 사양에 변경을 필요로 하지 않는다.
데이타베이스 통로는 WWW 서버의 종류에 따라 두 가지 방식으로 구현될 수 있다. 사용자 응용을 위한 확장 API를 지원하는 시스템의 경우(예, Nescape Commerce Server의 NSAPI)에는 이 API를 이용하여 데이타베이스 통로를 구현하고, WWW 서버는 이를 동적으로 링크하여 운영된다. 그러나, 이와 같은 확장 API를 지원하지 않는 WWW 서버에 데이타베이스 통로를 구현하기 위해서는 WWW 서버의 원천 코드를 변경, 추가해야 한다. 서버의 기능과 HTTP 통신 프로토콜이 빠르게 성장하고 있는 면을 감안하면 후자는 가능한 한 피해야 할 구현 방법이라 할 수 있다.
WWW 서버의 확장에 의한 통합은 CGI 방식에 비하여 다음과 같은 장점을 갖는다.
반면에 다음과 같은 단점을 가진다.
WWW 서버를 확장한 데이타베이스 통로의 사례는 CGI 방식에 비하여 상대적으로 적다. 다음은 이 중 몇가지를 열거한 것이며, 각각에 대한 보다 자세한 내용은 뒤에서 기술한다.
O2Web[10]은 프랑스의 O2 Technology사에서 개발할 데이타베이스 통로 제품으로서 O2 객체관계 DBMS에 접속되어 사용된다.
O2Web은 WWW 서버의 CGI를 이용한 구현되었다. WWW 서버는 CGI를 통하여 O2Web gateway에 연결되고, O2Web gateway는 O2Web dispatcher의 도움을 얻어 질의를 수행할 O2Web server를 찾는다. O2Web server는 OQL 객체지향 질의어로 표현된 사용자 질의를 수행하여 결과를 HTML 문서로 변환하여 반환한다.
O2Web은 o2report라는 메소드를 이용하여 질의 결과를 HTML 문서로 변환하는 프로그램을 구현하였다. 이 메소드는 복합 객체, 집합 등 O2 DBMS의 객체지향 스키마 구조를 충분히 활용하여 각 객체를 HTML 문서로 변환한다. 사용자는 응용에 따라 O2Web이 기본으로 지원하는 HTML 문서 변환 기능을 바꿀 수 있는데, 이는 사용자가 직접 o2report 메소드를 작성하여 시스템의 o2report 메소드를 대치함으로써 가능하다. O2 DBMS는 메소드 작성을 위해 C++, O2C와 같은 API를 지원한다.
InterServ[11]는 일본의 NTT Data Communications사에서 개발 중인 상용 제품으로서 UniSQL사의 UniSQL/X 객체관계 DBMS, 그리고 UniSQL/M 복수 DBMS에 연결되어 사용된다.
InterServ는 UniSQL/X의 클라이언트 프로그램으로서 HTTP 통신 규약을 지원한다. 즉, UniSQL/X를 DBMS로 갖는 전용 WWW 서버라 할 수 있다. InterServ는 HTML 문서를 UniSQL/X의 복합객체로 저장할 수 있고, 이를 다시 HTML 문서로 변환할 수도 있다. 모든 객체에 대하여 스키마 정보에 적합한 HTML 문서 변환이 가능하고, 사용자는 특정 객체나 클래스의 HTML 변환 형식을 바꿀 수도 있다. 이러한 목적으로 InterServ는 전용 스크립트 언어를 지원한다. InterServ는 UniSQL/X의 DBMS로서의 모든 기능(예, 질의 수행, 트랜잭션 관리, 사용자 권한 관리 등)을 WWW 서비스에 통합하여 사용할 수 있도록 한다.
NaviServer[12]는 NaviSoft사에서 개발 공급하는 상용 WWW 서버로서, Illustra 객체관계 DBMS에 대한 연결 기능을 포함하고 있다. 사용자는 WWW 기능과 Illustra DBMS의 기능을 혼합하여 응용을 개발할 수 있다.
WebRex[13]는 Information Technology Solutions사에서 개발 공급하는 WWW 서버로서 데이타베이스 통로를 내포하고 있다. 시연 시스템은 Oracle DBMS를 사용하고 있으나, CORBA 사양을 통해 다른 DBMS에도 연결할 수 있다.
WebDBC[14]는 Nomad Development사에서 개발 공급하고 있는 데이타베이스 통로로서 ODBC를 통하여 많은 종류의 DBMS에 연결하여 사용할 수 있다.
WebDBC는 CGI를 이용하여 구현되었다. WWW 서버는 CGI를 통하여 WebDBC에 연결되고, WebDBC는 사용자의 URL을 통해 지정된 HTX 화일을 적재하여 DBMS를 접속하는 데 필요한 질의를 형성한다. 질의는 ODBC를 통하여 DBMS에 전송되어 수행된다. 질의 수행 결과는 다시 HTX 화일에 표기된 사양대로 HTML 문서로 변환되어 WWW 서버에 전송된다.
사용자는 HTX 화일에 질의 화면(폼)과 질의 수행 결과의 HTML 문서 변환 방법을 기술한다. HTX 화일에는 HTML 마크업 뿐만 아니라, SQL 질의어를 위해 확장된 마크업 기능이 포함된다. 현재 WebDBC가 지원하는 SQL 질의어의 표현은 매우 제한되어 있어서, 두 개 이상의 테이블 결합(join), ORDER BY, GROUP BY 등이 필요한 많은 응용에서는 사용하기 힘들다.
WebBase[15]는 ExperTelligence사에서 개발 공급하고 있는 상용 WWW 서버로서, ODBC를 통해 많은 종류의 DBMS를 접속하는 기능을 내포하고 있다.
사용자 질의 결과의 HTML 문서 변환 방법은 .htf라는 화일에 기술된다. 이 화일은 확장된 HTML 마크업 언어로 기술되는데, SQL 문장, 변수, 함수, 매크로 등 여러 가지를 포함한다.
Web/Genera[16]는 Sybase DBMS를 위한 데이타베이스 통로로서 공용이다. Web/Genera는 WWW 서버와 CGI를 통하여 연결된다. WWW 서버는 sybgw라는 프로그램을 호출하면, sybgw는 URL로 주어진 요구를 인자로 하여 sybfmt라는 프로그램을 호출한다. sybfmt는 인자를 통하여 SQL 질의어를 구성하고 이를 DBMS를 통하여 수행한다음 결과를 HTML 문서로 변환한다.
Web/Genera는 데이타베이스에 저장된 자료를 HTML 문서로 변환하기 위하여 각 자료의 스키마 정보를 이용한다. 그런데, Sybase DBMS는 관계형 DBMS이기 때문에 각 자료의 실연 사양을 스키마에서 얻기에는 충분하지 않다. 이러한 문제점을 해결하기 위하여, Web/Genera는 Sybase 데이타베이스 스키마를 Web/Genera 스키마로 확장한다. Web/Genera 스키마는 객체라는 개념을 가지고 있으며 객체들간의 관계를 표현할 수 있도록 되어 있어서, 객체지향 모델에 가깝다.
Sybfmt라는 프로그램은 Web/Genera 스키마를 통하여, 사용자가 요구한 자료를 Sybase DBMS에서 검색하기 위한 절차, 검색된 결과를 HTML 문서로 변환하기 위한 방법 등을 구성한다.
LINCKS는 객체중심의 DBMS로서 최근에 WWW 접속을 위한 데이타베이스 통로가 개발되었다 [17]. 이 통로는 GNU 일반 공용 라이센스를 가진 프로그램이다. LINCKS용 데이타베이스 통로는 현재는 CGI를 이용하여 구현하였으나, 차후에 통로 기능을 내포한 전용 WWW 서버를 개발할 계획이다.
WWW 서버는 CGI를 통하여 cgi2lincks라는 스터브 프로그램을 호출하고, cgi2lincks는 검색하고자 하는 객체의 키와 URL을 w3lincks 프로그램에 전달한다. W3lincks는 요구된 객체를 검색하여 결과를 HTML 문서로 변환한다.
LINCKS에서는 객체의 시각화(visualization) 사양을 GPD(generic presentation descriptor)에 의하여 기술된다. GPD는 객체를 HTML 문서로 변환하는 데 필요한 여러 가지 형식 및 구성 정보를 기술하는데, 그 구조는 SGML과 유사하다. 특히, GPD에 기술되는 형식 정보는 매크로, 변수, 함수 등을 포함하는 작은 규모의 언어로 기술된다.
OWIK[18]는 Oracle DBMS에 접속할 수 있는 데이타베이스 통로의 집합으로서 서로 독립적으로 개발된 공용 소프트웨어를 Oracle사에서 묶음으로 공급하는 것이다. OWIK는 WOW, WORA, Decoux, ORAYWWW, 그리고 TSS로 이루어져 있다. 모두 CGI를 이용하여 구현되었다. 각각에 대하여 특기할 만한 사항은, WOW는 Oracle의 내장절차인 PL/SQL을 이용하였고, Decoux는 SQL을 위해 HTML 마크업 기능을 확장하였으며, ORAYWWW에서는 WWW 브라우져를 통해 질의 폼을 구성할 수 있고, WORA는 WWW을 통한 대화형 SQL 질의 인터페이스라 할 수 있고, TSS는 WOW를 이용한 전문 검색 응용에 사용할 수 있다는 점이다.
데이타베이스 통로는 앞에서 열거한 것들 외에도 많은 제품이 있다. 이들을 간략히 열거하면 다음과 같다.
GSQL은 폼을 통하여 데이타베이스를 접속하는 데 이용할 수 있는 공용 프로그램이다. GSQL은 WWW 서버의 CGI를 이용하여 연결된다. GSQL을 이용하여 접속될 수 있는 데이타베이스 엔진은 SQL을 지원하고 있어야 한다. 특정 DBMS에 접속하여 사용하기 위해서는 간단한 몇가지 환경 설정만 하면 된다. < 그림 7 > 는 GSQL을 이용하여 UniSQL/X DBMS 엔진을 접속하는 구조를 보인 것이다.
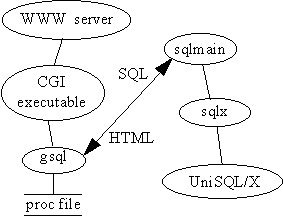
< 그림 7 > GSQL의 실행 구조
아래 C-shell 스크립트는 CGI 실행 화일의 예제를 보인 것이다.
#!/bin/csh -f
#

# set UniSQL/X environment which are likely common to all PROC files
source unisqlx_env

# dispatch the sample PROC file
./gsql sample.proc $QUERY_STRING
즉, UniSQL/X 응용 프로그램의 실행환경을 설정한 후 지정된 proc 화일명과 사용자가 입력한 값을 gsql 프로그램에 전달한다. 여기서 UniSQL/X 환경의 예제는 다음과 같다.
setenv UNISQLX		/extra_vol1/UniSQL3.1
setenv UNISQL4GE	$UNISQLX
setenv UNISQLX_LANG	Ko_KR
setenv UNISQLX_CHARSET	EUC
setenv UNISQLX_DATABASES /users/pckim/project/gsql-unisqlx/database
setenv UNISQLX_MODE	client
setenv XNLSPATH		/usr/lib/X11/nls
setenv XKEYSYMDB	/usr/lib/X11/XKeysymDB
setenv MotifLANG	korean
setenv LD_LIBRARY_PATH	$UNISQLX/lib
setenv PATH		$UNISQLX/bin:$UNISQLX/utilities:$PATH
사용자는 각 응용마다 proc 화일을 작성한다. Proc 화일에는 사용자 화면을 어떻게 구성할 것인지, 사용자로부터 어떤 입력을 받을 것인지, 이를 이용하여 어떻게 SQL 문장을 형성할 것인지, 형성된 SQL 문장을 수행할 데이타베이스 응용 프로그램의 경로명은 무엇인지 등을 포함되게 된다. 다음은 proc 화일의 간단한 예제이다.
HEADING   < H2 > GSQL을 이용한 UniSQL/X 사용 예제 < /H2 > ;
TEXT < HR > ;
TEXT < P > 이 예제는 너무도 단순한 것으로서 GSQL에 UniSQL/X가 쉽게 붙을 수
	있슴을 보이기 위한 것입니다. 우리는 GSQL이 기능 및 구조 측면에서
	대규모 서비스 시스템 개발에 적합하지 않다고 보고 있으며, 대안으로
	< A HREF="/~uniweb" > UniWeb < /A > 을 개발하고 있습니다.;
TEXT < HR > ;

SUB	name		SELECTLIST AS name;
SUB	age		SELECTLIST AS age;
SUB	dept		SELECTLIST AS dept;
SUB	telephone	SELECTLIST AS telephone;

SUB	_attrlist	SELECTLIST variable $;
SHOW	_attrlist	TITLE "< P > 보고자 하는 항목을 선택하시오." SCROLL
			name, age, dept, telephone;

SUB	under-30	WHERELIST AS age < 30;
SUB	30-39		WHERELIST AS age > = 30 and age < 40;
SUB	40-49		WHERELIST AS age > = 40 and age < 50;
SUB	50-59		WHERELIST AS age > = 50 and age < 60;
SUB	over-60		WHERELIST AS age > = 60;

SUB	_agelist	WHERELIST variable $;
SHOW	_agelist	TITLE "< P gt 연령의 범위를 선택하시오" PULLDOWN
			under-30, 30-39, 40-49, 50-59, over-60;

SQLPROG 	/users/pckim/project/gsql-unisqlx/sqlmain;
FROMLIST	professor;

#
# define PROC-specific information
#
# name of the database to connect
DEFINE	DATABASE		sample_db;
#
# login name
DEFINE  LOGIN			public;
#
# and password (if necessary)
#DEFINE  PASSWORD		something;
사용자가 WWW 브라우저를 이용하여 CGI 용 실행 화일의 URL을 요구하면 다음과 같은 절차를 거쳐 데이타베이스 접근이 이루어진다.
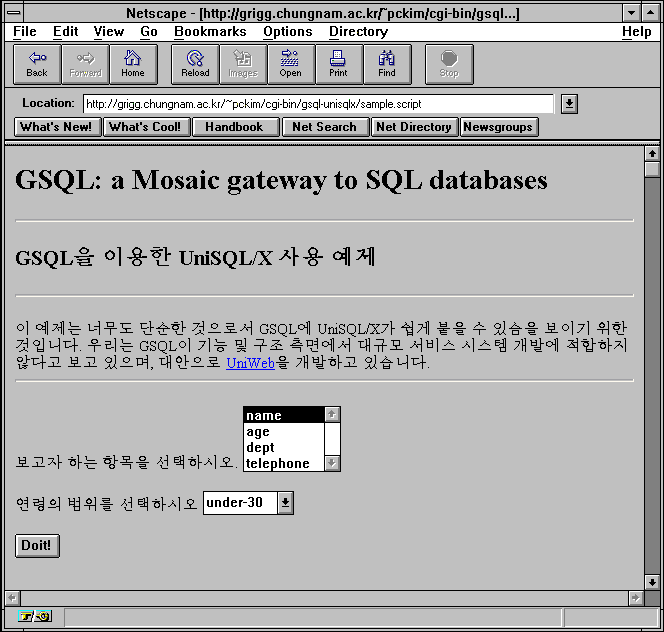
< 그림 8 > 예제 proc 화일에 대한 화면
GSQL이 제공하는 폼 정의 및 이를 통한 SQL 언어 생성 기능은 매우 제한되어 있다. 예를 들면, SELECT를 제외한 다른 데이타베이스 언어는 사용할 수 없고, SELECT 문의 경우에도 부질의와 같이 복잡한 형태는 사용할 수 없다.
UniWeb[24]은 한국컴퓨터통신(주)의 지원을 받아 충남대학교 정보통신공학과에서 개발하고 있는 UniSQL/X용 WWW 데이타베이스 통로이다. UniWeb의 주요 응용은 대규모 멀티미디어 데이타베이스 서비스로서 전자박물관, 전자미술관, 전자신문 등이 대표적인 예라 할 수 있다.
먼저 UniWeb의 구조에 대하여 기술하고, 다음으로 사용자 측면에서 본 UniWeb의 기능을 기술한 후, 마지막으로 향후 확장에 대하여 기술하도록 한다.
GSQL과 같은 데이타베이스 통로는 데이타베이스 접속시마다 새로운 프로세스가 생성되어 실행된 후 종료된다. 따라서 프로세스의 생성 및 종료 등과 같은 성능 부담이 적지 않다. UniWeb은 데이타베이스 검색 및 HTML 문서 변환 등의 기능을 수행하는 데이타베이스 통로 프로세스와 WWW 서버의 CGI에 의하여 시동되는 디스패처(dispatcher) 프로세스로 나누어져 있고, 이중 데이타베이스 통로 프로세스는 데몬 방식으로 되어 있어서 프로세스의 반복 생성 및 데이타베이스 반복 접속시 발생할 수 있는 성능 부담을 최소화하였다. < 그림 9 > 는 UniWeb 데이타베이스 통로의 구조를 보인 것이다.
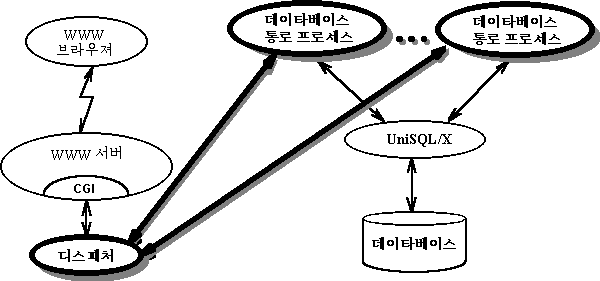
< 그림 9 > UniWeb 데이타베이스 통로의 구조
디스패처는 WWW 서버의 CGI 기능으로부터 호출된다. 따라서 사용자가 데이타베이스에 접근할 때마다 새로이 실행된다. 디스패처는 사용자가 요구한 URL을 WWW 서버로부터 전달받아 분석하여, 데이타베이스 접근 요구일 경우 데몬으로 실행 중인 데이타베이스 통로 프로세스에 전달하고 다른 데이타베이스 응용 프로그램 실행일 경우 해당 응용 프로그램을 수행한다.
디스패처는 사용자 접속을 관리하여, 데이타베이스 검색 및 응용 프로그램 수행 권한을 검사한다. HTTP는 접속상태를 유지하지 않는(stateless) 통신 프로토콜이기 때문에 한 사용자의 계속적인 데이타베이스 접속을 판단하는 것이 쉽지 않다. 이 때문에 많은 데이타베이스 통로가 데이타베이스를 접속할 때마다 로그인 정보를 사용자에게서 받거나 혹은 이미 작성된 폼 화일에 기록하여 두고 있다. UniWeb은 이 문제를 HTML 문서 변환시 숨겨진 항목(hidden field)이나 URL에 접속 상태를 첨부시킴으로서 해결하고 있다.
데이타베이스 통로 프로세스의 주요 기능은 데이타베이스를 검색하여 그 결과를 HTML 문서로 변환하는 것이다. 통로 프로세스의 갯수는 시스템의 상태와 사용자 요구의 많고 적음에 따라 적절하게 조정되어, 동적으로 변하는 서비스 부하에 최적의 성능을 가질 수 있도록 설계되어 있다.
< 그림 10 > 은 UniWeb에서 사용자의 데이타베이스 검색 요구가 수행되는 과정을 나타낸 것이다.
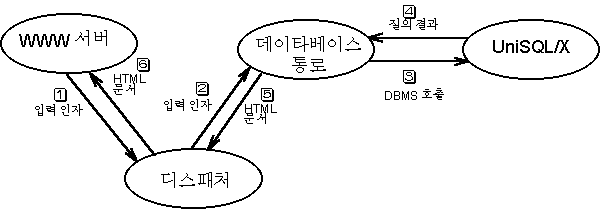
< 그림 10 > UniWeb에서 데이타베이스 요구의 수행 과정
디스패처는 WWW 서버로부터 여러 가지 입력 인자를 받는다. 일부는 PATH_INFO를 통하여, 일부는 QUERY_STRING을 통하여 받는다. 디스패처는 입력 인자를 통하여 질의 요구, 개별 객체 요구, 다른 응용 프로그램 호출 등을 판별하고, 적절하게 데이타베이스 통로를 호출한다. 이때, 데이타베이스 통로에 전달되는 인자는 사용자 로그인 정보, 질의문, 객체 식별자 등이 될 수 있다.
데이타베이스 통로는 디스패처에서 받은 입력 인자를 UniSQL/X를 통하여 처리한 후, 그 결과를 HTML 문서로 변환하여 디스패처에 전송한다. 디스패처는 HTML 문서를 WWW 서버로 전달한다.
사용자의 데이타베이스 검색 화면은 HTML의 폼 기능을 이용하여 작성될 수 있다. 따라서, 일반적인 HTML 편집기를 이용하면 된다. 다만, 폼에서 입력된 값을 토대로 구성될 데이타베이스 질의어는 HTML 폼 기능만으로는 안된다. 이를 위해서, UniWeb은 질의 매크로 화일을 지원한다. 질의 매크로 화일은 매크로를 포함하는 SQL/X(UniSQL/X의 질의어) 문장이 저장된다. 폼을 통해 제출된 URL에는 질의 매크로 화일명과 사용자의 입력값이 결부되어 있다. 이를 이용하여 디스패처는 완전한 질의어를 작성할 수 있다.
일반적으로 하나의 HTML 문서는 다른 자료에 대한 앵커를 다수 포함하고 있다. 데이타베이스의 자료의 경우에도 하나의 자료가 다른 여러 자료와 관계를 가지고 있는 것이 일반적이다. 자료간의 관계는 HTML의 앵커로 표현할 수 있다. UniWeb은 하나의 객체을 HTML 문서로 변환할 때, 이와 관련된 객체에 대한 앵커를 생성한다. 이 앵커에는 객체 식별자 정보가 기록되어 있어서, 사용자가 앵커를 선택하면 객체 식별자를 이용하여 신속하게 해당 객체를 검색하여 준다. 다른 데이타베이스 통로가 모든 객체 검색에 대하여 SQL과 같은 데이타베이스 언어를 사용하도록 되어 있는 것에 비하여 훨씬 빠른 성능을 제공할 것이다.
데이타베이스에 저장된 객체는 갯수도 많을 뿐더러 종류도 매우 다양하다. 일반적으로 서로 다른 종류의 객체는 각기 다른 형태의 실연이 필요하다. 많은 종류의 객체에 대한 실연 사양을 응용 프로그래머가 일일이 지정해주어야 한다면 서비스 개발의 생산성에 큰 문제가 될 것이다. 따라서, 데이타베이스 통로는 데이타베이스에 저장된 자료에 대하여 적절한 HTML 문서 변환을 지원해야 한다. UniWeb은 각 객체의 스키마 정보를 기반으로 적절한 HTML 문서를 작성해준다. 특히, UniSQL/X의 데이타 모델은 복합객체, 집합 등을 지원하고 있어서 스키마를 이용한 HTML 문서 변환은 매우 자연스러운 실연 효과를 갖는다. 이 방식은 검색 결과마다 실연 사양을 따로이 명시해야 하는 다른 데이타베이스 통로에 비하여 생산성이 훨씬 우수하다.
UniSQL/X는 데이타 모델을 이용하면, 한 객체와 다른 객체간의 관계를 보다 명확히 표현할 수 있다. UniWeb은 질의 결과로 주어진 객체를 스키마를 이용하여 자동적으로 HTML 문서로 변환한다. 이때, 해당 객체와 다른 객체간의 관계는 앵커로 변환되어 사용자는 객체들간의 관계를 하이퍼미디어 방식으로 브라우즈할 수 있다.
UniWeb이 지원하는 기본 HTML 문서 변환 방법을 사용자 편의에 따라 변경할 수 있다. 또한, 필요에 따라서는 동일한 자료를 요구에 따라 서로 다른 HTML 문서로 변환할 수도 있다. 예를 들면 "지난해의 월평균 강우량"을 사용자의 선택에 따라 텍스트 또는 그래프로 표시할 수 있다.
디스패처는 사용자 접속을 관리하여, 데이타베이스 검색 및 응용 프로그램 수행 권한을 검사한다. 이 기능은 UniSQL/X의 자료 접근 권한 관리 기능을 충분히 활용한다.
경우에 따라서는 단순한 SQL 문의 수행만으로는 원하는 결과를 얻을 수 없을 때가 있다. 예를 들어 데이타베이스에는 "지난해의 일별 강우량" 만이 저장되어 있다고 하자. 이때, "지난해의 월평균 강우량"과 같은 정보는 검색 결과를 응용 프로그램으로 가공하여야 얻을 수 있다. 이러한 경우를 위하여 UniWeb은 응용 프로그램 수행 기능을 제공한다.
WWW 서버의 CGI 기능만을 이용하여도 이러한 기능을 구현할 수 있다. 그러나 사용자의 로그인 및 접근 권한을 효율적이고 일관적으로 처리하기가 어렵다.
UniWeb은 현재 설계가 완료되어 95년 10월말까지는 구현이 완료될 것이다. 우리는 향후 UniWeb 데이타베이스 통로를 다음과 같이 확장할 계획이다.
WWW은 대규모 멀티미디어 정보 서비스 시스템으로서 많은 우수성을 갖는 반면, 대량의 자료를 가진 데이타베이스 서비스를 개발하는 데에는 문제가 많다. 반면, 기존의 데이타베이스 시스템은 방대한 데이타베이스 관리 기능과 응용 개발 도구 등의 우수성을 갖고 있으나 폼의 관리 방식과 표준 부재 등의 이유로 대규모 서비스 시스템을 구축하기에는 적합하지 않다. 따라서, 대규모 멀티미디어 데이타베이스 서비스 시스템은 WWW와 데이타베이스 시스템 기술의 상호 보완적인 통합이 필요하다. 데이타베이스 통로는 이러한 통합의 핵심적인 소프트웨어라 할 수 있다.
데이타베이스 통로의 구현은 WWW 서버의 CGI를 이용하는 방식과 WWW 서버 자체를 확장하는 방식으로 나눌 수 있다. CGI를 이용하는 방식은 구현 및 확장이 용이하다는 장점을 갖는 반면 프로세스 생성 및 프로세스간 자료 복사로 인해 성능이 저하된다는 단점을 갖고 있다. WWW 서버를 확장하는 방식은 성능은 우수하나 구현 및 확장이 어렵고, 사용자 입장에서 다른 서버와 호환성이 없는 전용 서버를 사용해야 한다는 단점이 있다.
WWW과 데이타베이스의 연동에 대한 필요성이 급증함에 따라 많은 데이타베이스 통로가 개발되어 왔다. 본 문서에서는 이들에 대하여 간략하게 조사해보았고, 특히, UniSQL/X에 접속될 수 있는 GSQL의 구현과, 현재 충남대학교 정보통신공학과에서 개발 중인 UniWeb에 대하여 자세하게 기술하였다.
통신 기술, 멀티미디어 처리 기술, 그리고 컴퓨터 기술의 급속한 발전으로 앞으로 멀티미디어 데이타베이스 서비스 요구는 급격하게 증가될 것으로 보인다. 이러한 측면에서 WWW과 데이타베이스 통합을 위한 데이타베이스 통로의 개발도 더욱 왕성해질 것이다. 우리는 UniWeb 프로젝트를 통하여 바로 이러한 요구에 부응하는 데이타베이스 통로를 개발할 것이다.